كيف يعمل تقطيع الفيديو بالذكاء الاصطناعي ولماذا يهمك
تحوّل التقطيع بالذكاء الاصطناعي من مجرد تجربة طريفة إلى أداة إنتاج حقيقية في أقل من عامين. ما كان يحتاج إلى محرر بشري يشاهد ساعات من اللقطات ويحكم بحسّه على الإيقاع والمشاعر، صارت نماذج تعلّم الآلة تنجزه في دقائق. لكن كيف يعمل ذلك فعلًا؟ ولماذا تُخرج بعض الأدوات مقاطع تبدو طبيعية، بينما تقطّع أخرى الفيديو عند حدود عشوائية لا معنى لها؟
الجواب في ما يحلّله الذكاء الاصطناعي فعلًا. أدوات المونتاج التلقائي ليست سواء، والفرق بين أداة متوسطة وأخرى ممتازة يرجع إلى قرار معماري واحد: هل ينظر النظام إلى النص المفرّغ وحده، أم إلى الإشارة السمعية البصرية كاملة؟
نهج النص المفرّغ وحده
تعمل معظم أدوات التقطيع بالذكاء الاصطناعي من الجيل الأول هكذا: تحوّل الصوت إلى نص بتقنية تحويل الكلام إلى نص، ثم تمرّر النص المفرّغ إلى نموذج لغوي وتطلب منه تحديد الأجزاء «المثيرة للاهتمام». يختار النموذج الجمل التي تبدو مهمة، ويعيد ربطها بتوقيتاتها، ثم يقطع الفيديو عند تلك النقاط.
هذا النهج سريع ورخيص البناء، فهو يستفيد من النماذج اللغوية الكبيرة الموجودة أصلًا والبارعة جدًا في فهم النصوص. ومع بعض أنواع المحتوى — كالمقابلات التي تحمل خلاصات لفظية واضحة — يؤدي عمله بشكل معقول.
لكن فيه نقاطًا عمياء جوهرية:
- لا يرى. اللحظات البصرية البحتة — عرض منتج، لقطة رد فعل، كشف مفاجئ — لا وجود لها بالنسبة لنظام يعتمد على النص المفرّغ.
- تفوته النبرة والطاقة. عبارة «هذا مذهل» قد تُقال بحماس حقيقي أو بسخرية باردة، والنص المفرّغ يبدو هو نفسه في الحالتين.
- يقطع عند حدود الجمل. نقاط القطع الطبيعية نادرًا ما تتطابق مع نهايات الجمل. قد يبدأ مقطع رائع في منتصف جملة مع رد فعل، وينتهي على لحظة بصرية.
- يتجاهل الإيقاع. إيقاع المحادثة — الوقفات والضحك وتداخل الكلام — يحمل معلومات عاطفية لا يستطيع النص وحده التقاطها.
أدوات النص المفرّغ وحده تُخرج مقاطع لها صلة بالموضوع، لكنها كثيرًا ما تبدو كأن أحدهم قصّ المحادثة بمقص عند نقاط عشوائية. المحتوى صحيح، لكن التوقيت في غير مكانه.
النهج متعدد الوسائط: تحليل بصري + سمعي
نظام التقطيع متعدد الوسائط يعالج عدة تدفقات من البيانات في الوقت نفسه: الإطارات المرئية، والإشارة الصوتية، والنص المفرّغ. كل تدفق يقدّم معلومات مختلفة، والنظام يجمعها ليتخذ قرارات لا يستطيع أي تدفق منفرد أن يسندها وحده.
التحليل البصري
يُعالَج المسار البصري بنماذج رؤية حاسوبية ترصد عدة عناصر وتتتبعها:
- تغيّر المشاهد. القطعات الحادة والتلاشيات والتغيّرات الكبيرة في التكوين البصري تشير إلى انتقالات بين المواضيع أو الأجزاء.
- رصد الوجوه وتتبعها. يحدد النموذج من يتحدث، وتعابير وجهه، وحالته العاطفية. حاجب مرفوع، أو ابتسامة تفلت، أو نظرة دهشة — كلها تحمل معنى.
- الحركة والطاقة. الإيماءات السريعة أو الميل إلى الأمام أو الوقوف تدل على لحظات تأكيد. أما الإطارات الساكنة منخفضة الطاقة فغالبًا ما تكون حشوًا.
- العناصر الظاهرة على الشاشة. النصوص المعروضة فوق الصورة، والشرائح، ولقطات المنتجات، ومشاركة الشاشة قد تدل على أجزاء منظّمة تستحق الحفظ كمقاطع مستقلة.
التحليل الصوتي
بعيدًا عن التفريغ النصي، تحمل الإشارة الصوتية نفسها معلومات غنية:
- طاقة الصوت وطبقته. ارتفاع الطبقة وازدياد علو الصوت يدلّان على حماس أو تأكيد، وهذه اللحظات ترتبط بقوة بتفاعل المشاهدين.
- الضحك وردود الفعل. ضحك الجمهور أو شهقاته أو تصفيقه علامات قوية على مقطع يستحق، وأدوات النص المفرّغ وحده تفوتها تمامًا.
- الصمت والوقفات. الوقفات المقصودة كثيرًا ما تسبق العبارات المهمة أو تليها، وهي أيضًا نقاط قطع طبيعية.
- الموسيقى والتصميم الصوتي. تحوّلات الموسيقى الخلفية، والمؤثرات الصوتية، ونغمات المقدمة والخاتمة تساعد الذكاء الاصطناعي على تحديد الحدود البنيوية في المحتوى المُنتَج باحتراف.
دمج الإشارات
القوة الحقيقية تظهر عند دمج هذه التدفقات. تخيّل حلقة بودكاست يقول فيها المضيف شيئًا مثيرًا بعض الشيء — قد لا يلفت النص المفرّغ وحده الانتباه إليه. لكن إن اتسعت عينا الضيف، ومال إلى الأمام، وقفزت نبرة صوته، وقاطع قائلًا «لحظة، أعد ما قلته» — فإن النظام متعدد الوسائط يتعرّف عليها كلحظة تفاعل عالٍ، لأن كل الإشارات تلتقي عندها.
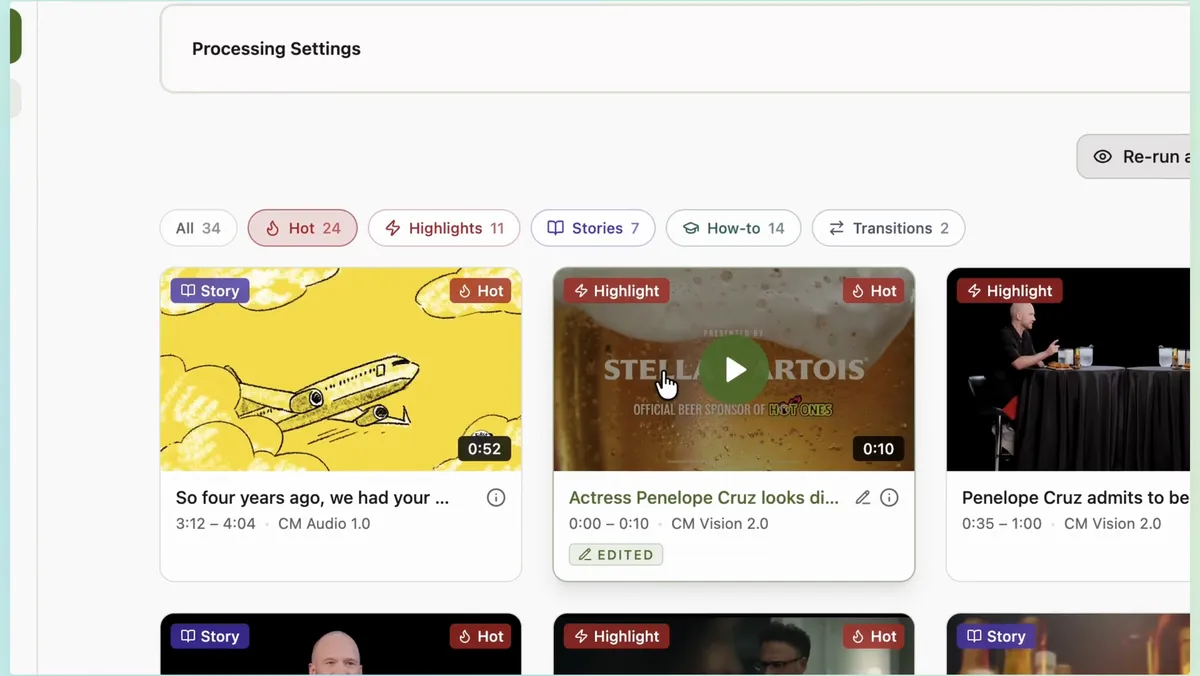
هكذا يعمل الذكاء الاصطناعي في ClipMaster. لا يكتفي بقراءة ما قيل — بل يشاهد ويستمع ليفهم كيف قيل، وكيف تفاعل الناس معه. والنتيجة مقاطع تلتقط لحظات طاقة حقيقية، لا مجرد فقرات نصية لها صلة بالموضوع.
تقييم المقاطع وترتيبها
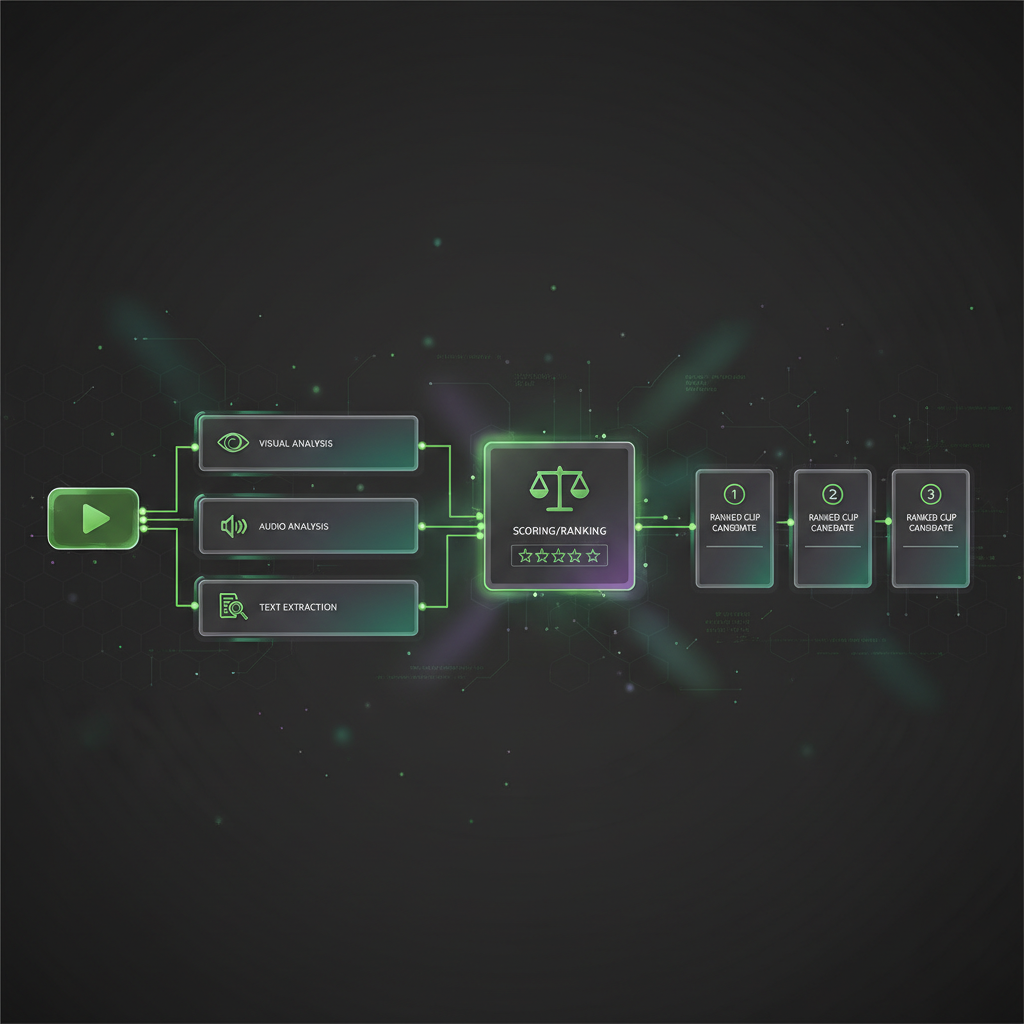
بعد أن يعالج الذكاء الاصطناعي التدفقات الثلاثة، يولّد مجموعة من المقاطع المرشحة ويمنح كلًا منها درجة. ويأخذ نموذج التقييم في الحسبان عدة عوامل:
- قابلية التفاعل. ما احتمال أن يشدّ هذا المقطع انتباه المشاهد من البداية إلى النهاية؟ المقاطع ذات البدايات القوية والخواتيم الواضحة تنال درجات أعلى.
- الاكتفاء الذاتي. هل يُفهم المقطع دون سياق إضافي؟ اللحظة التي تحتاج إلى خمس دقائق من التمهيد لتُفهم تنال درجة أقل من لحظة تشرح نفسها بنفسها.
- المسار العاطفي. أفضل المقاطع القصيرة تحمل قصة مصغّرة — تمهيد، ثم ذروة، ثم خاتمة. ويبحث الذكاء الاصطناعي عن هذا المسار في كل جزء مرشح.
- الجودة التقنية. المقاطع التي يظهر فيها المتحدث بوضوح، وصوتها نقي، وتأطيرها ثابت، تنال درجات أعلى من المقاطع ضعيفة الإنتاج.
الناتج قائمة مرتّبة من المقاطع، عادةً حسب درجة التفاعل. يراجعها صانع المحتوى، ويعدّل ما يلزم، ثم يصدّر ما ينجح منها.
البحث الدلالي في الفيديو: العثور على اللحظات بمعناها
من أقوى القدرات التي يتيحها التحليل متعدد الوسائط: البحث الدلالي. فبدل البحث عن كلمات بعينها في النص المفرّغ، يتيح لك البحث الدلالي أن تصف ما تبحث عنه بلغة طبيعية، فيجد الذكاء الاصطناعي اللحظات المطابقة — حتى لو لم تُنطق تلك الكلمات أبدًا.
مثلًا، البحث عن «لحظة يعترض فيها الضيف» سيجد مقاطع يظهر فيها الاعتراض عبر لغة الجسد والنبرة والكلمات — لا مجرد مقاطع تحتوي كلمة «أعترض». وهذا يختلف جذريًا عن البحث بالكلمات المفتاحية، وأسرع بكثير من التنقّل يدويًا عبر اللقطات.
لماذا يهمّ هذا صنّاع المحتوى
الانتقال من التقطيع المعتمد على النص المفرّغ وحده إلى التقطيع متعدد الوسائط ليس مجرد تحسين تقني — بل يغيّر أنواع المحتوى التي يمكن تقطيعها بفعالية.
- المحتوى البصري يصبح قابلًا للتقطيع. عروض الطبخ، ومراجعات المنتجات، ودروس اللياقة، ومدونات السفر المصوّرة كلها تعتمد بشدة على الصورة. أدوات النص المفرّغ وحده تتعثر معها، أما الأدوات متعددة الوسائط فتتعامل معها بسلاسة.
- اللحظات العاطفية لا تضيع. أطرف لحظات الفيديو وأكثرها تأثيرًا ومفاجأة تصنعها المشاعر لا الكلمات. والتحليل متعدد الوسائط يلتقط ما يعجز عنه تحليل النص.
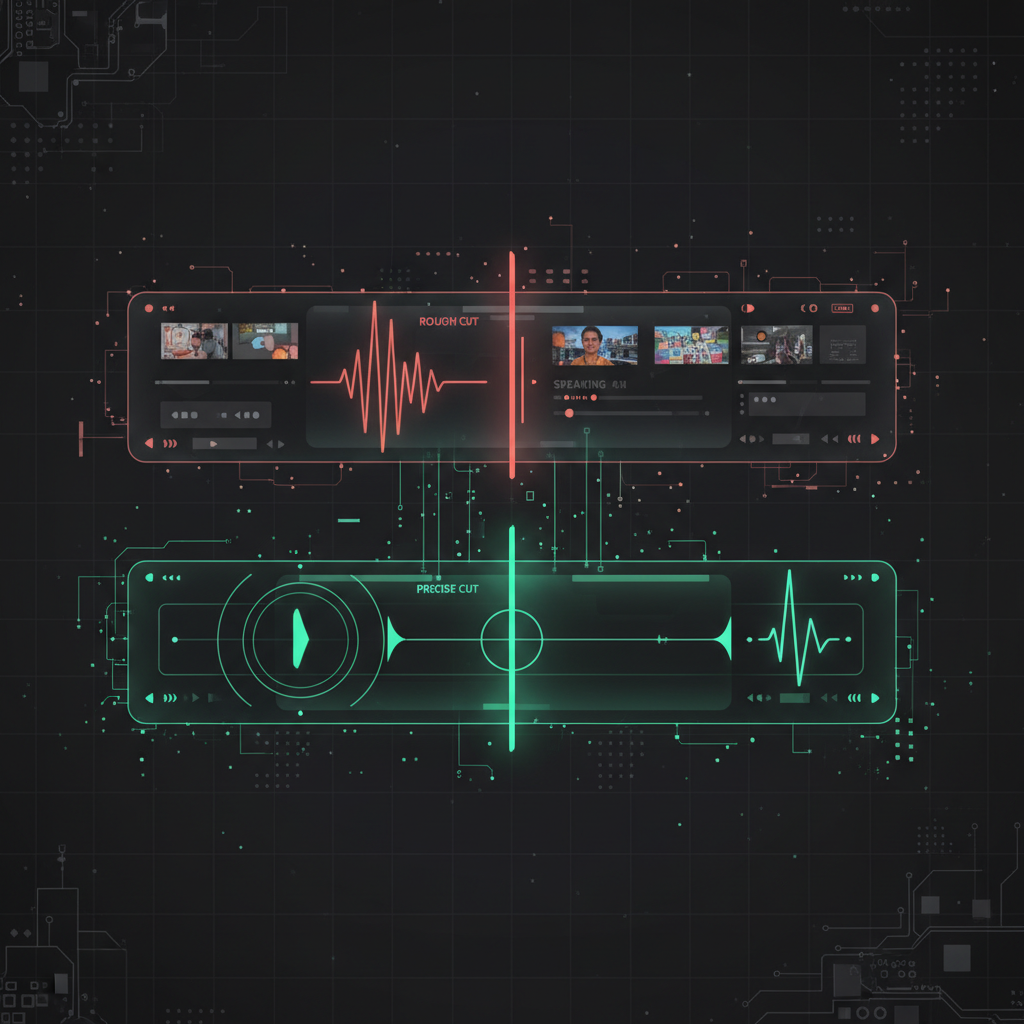
- المونتاج يبدو بشريًا. لأن الذكاء الاصطناعي يستخدم الإشارات نفسها التي يعتمدها المحرر البشري — التعابير والطاقة والإيقاع — تبدو المقاطع الناتجة كأن من قطّعها شخص شاهد الفيديو فعلًا.
ما الذي ينتظرنا
التقطيع بالذكاء الاصطناعي يتحسن بسرعة. النماذج تزداد براعة في فهم السياق والفكاهة والبنية السردية وتفضيلات الجمهور. والمحطة التالية هي التخصيص — ذكاء اصطناعي يتعلّم أي أنواع المقاطع تحقق أفضل أداء مع جمهورك تحديدًا، ويعدّل اختياراته على هذا الأساس.
لكن المبدأ الأساسي سيبقى كما هو: كلما فهم الذكاء الاصطناعي ما يشاهده أكثر، كانت قراراته في المونتاج أفضل. التحليل متعدد الوسائط ليس ميزة إضافية — بل هو الأساس الذي يفصل أدوات الفيديو المبنية على تعلّم الآلة التي تُخرج مقاطع صالحة للنشر، عن تلك التي تُخرج مسودات خامًا. وإن كنت تقارن بين أدوات التقطيع بالذكاء الاصطناعي، فالسؤال الأول بسيط: هل تشاهد الأداة الفيديو فعلًا، أم تكتفي بقراءة النص المفرّغ؟