Comment fonctionne la création de clips vidéo par IA et pourquoi c'est important
Le découpage vidéo par IA est passé de la nouveauté à l'outil de production en moins de deux ans. Ce qui nécessitait auparavant qu'un monteur humain visionne des heures de séquences, prenant des décisions sur le rythme et l'émotion, peut désormais être réalisé par des modèles d'apprentissage automatique en quelques minutes. Mais comment cela fonctionne-t-il réellement ? Et pourquoi certains outils produisent-ils des clips qui semblent naturels, tandis que d'autres coupent les vidéos à des moments maladroits et dénués de sens ?
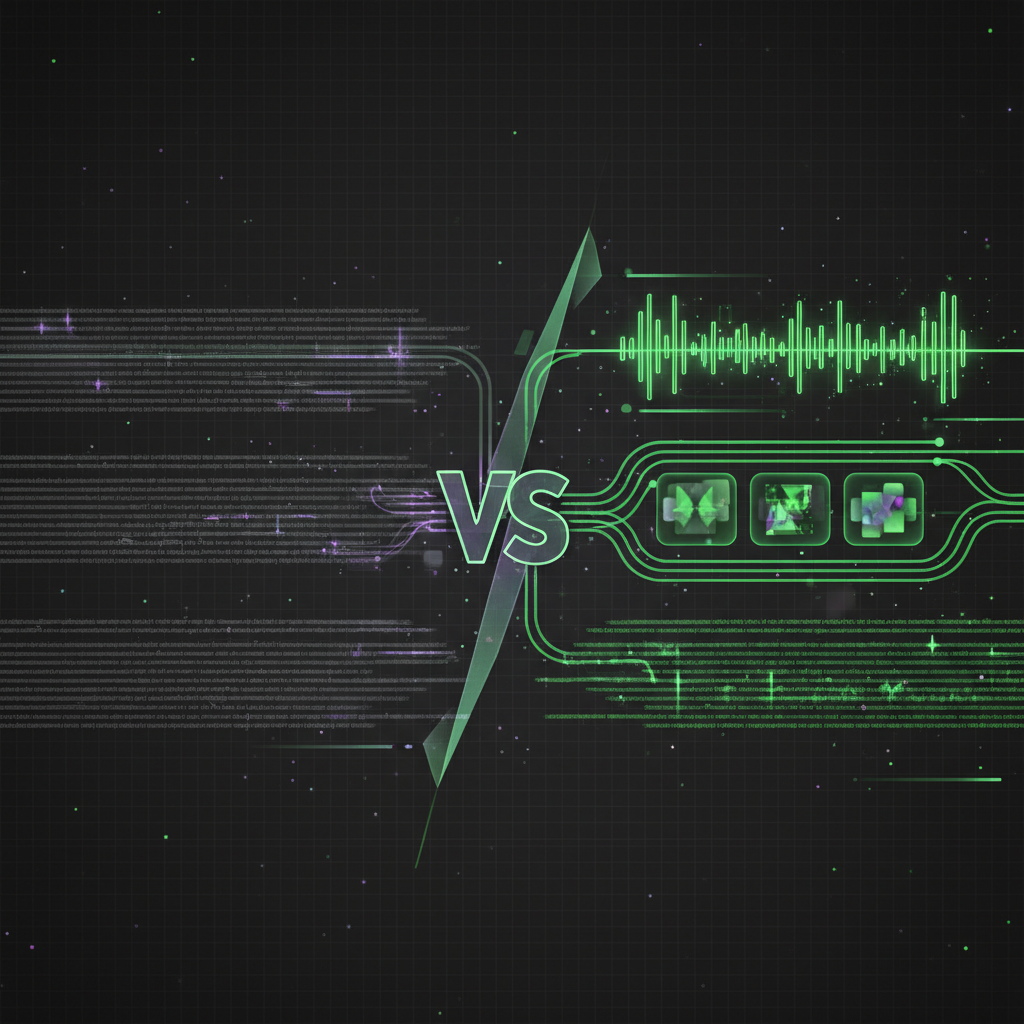
La réponse réside dans ce que l'IA analyse réellement. Tous les outils de montage vidéo automatique ne sont pas égaux, et la différence entre un outil médiocre et un excellent se résume à une seule décision architecturale : le système examine-t-il uniquement la transcription, ou le signal audiovisuel complet ?
L'approche basée uniquement sur la transcription
La plupart des outils de découpage par IA de première génération fonctionnent ainsi : ils transcrivent l'audio à l'aide de la reconnaissance vocale, font passer la transcription à travers un modèle linguistique, et lui demandent d'identifier les segments "intéressants". Le modèle sélectionne les phrases qui semblent importantes, les associe à des horodatages, et coupe la vidéo à ces points.
Cette approche est rapide et peu coûteuse à développer. Elle s'appuie sur des modèles de langage étendus existants qui sont très performants pour comprendre le texte. Pour certains types de contenu — comme les interviews avec des points clés verbaux clairs — elle fonctionne raisonnablement bien.
Mais elle présente des lacunes fondamentales :
- Elle ne peut pas voir. Les moments purement visuels — une démonstration de produit, un plan de réaction, une révélation dramatique — sont invisibles pour un système basé sur la transcription.
- Elle manque de ton et d'énergie. Les mots "c'est incroyable" peuvent être prononcés avec un enthousiasme sincère ou un sarcasme impassible. La transcription est la même dans les deux cas.
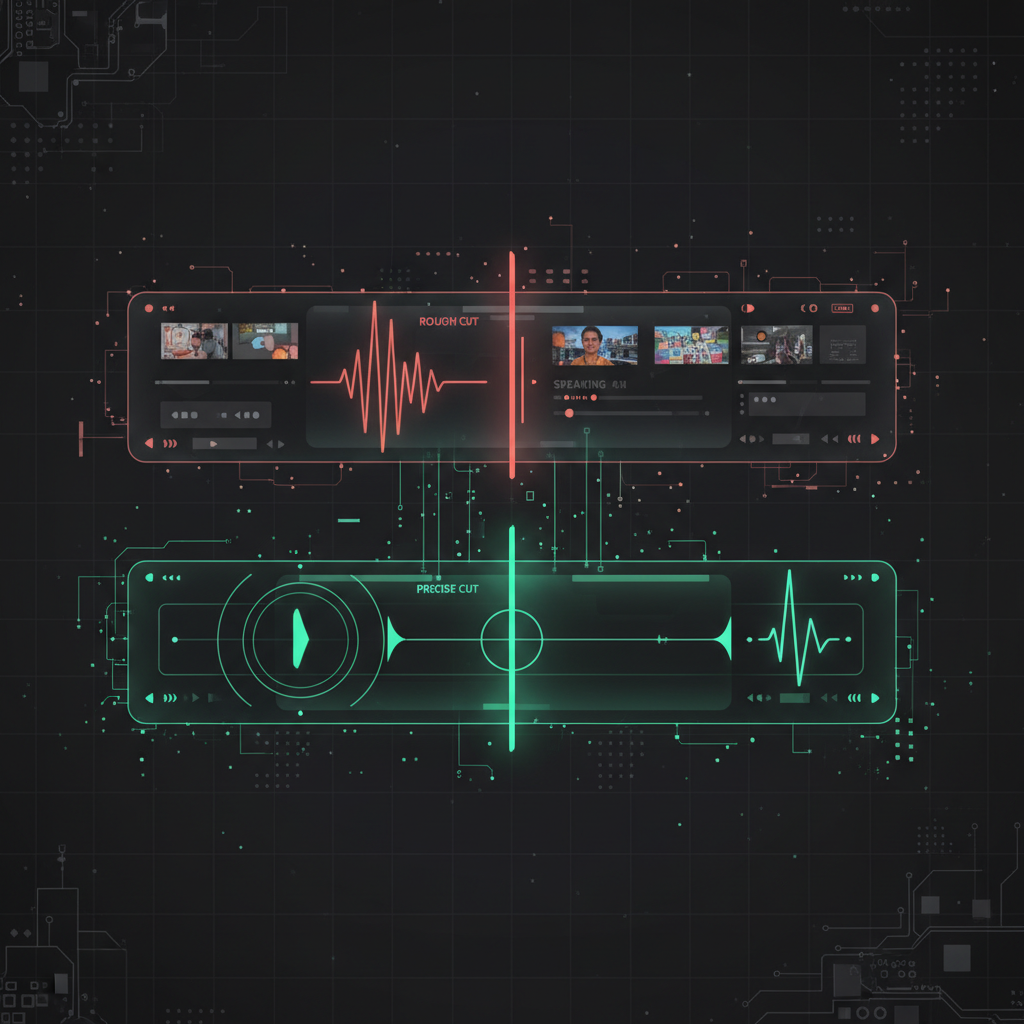
- Elle coupe aux limites des phrases. Les points de découpe naturels coïncident rarement avec la fin des phrases. Un excellent clip pourrait commencer au milieu d'une phrase avec une réaction et se terminer sur un temps visuel.
- Elle ignore le rythme. Le rythme d'une conversation — pauses, rires, chevauchement de paroles — véhicule des informations émotionnelles que le texte seul ne peut pas capturer.
Les outils basés uniquement sur la transcription produisent des clips thématiquement pertinents, mais qui donnent souvent l'impression que quelqu'un a coupé une conversation avec des ciseaux à des moments aléatoires. Le contenu est juste, mais le timing est mauvais.
L'approche multimodale : analyse visuelle + audio
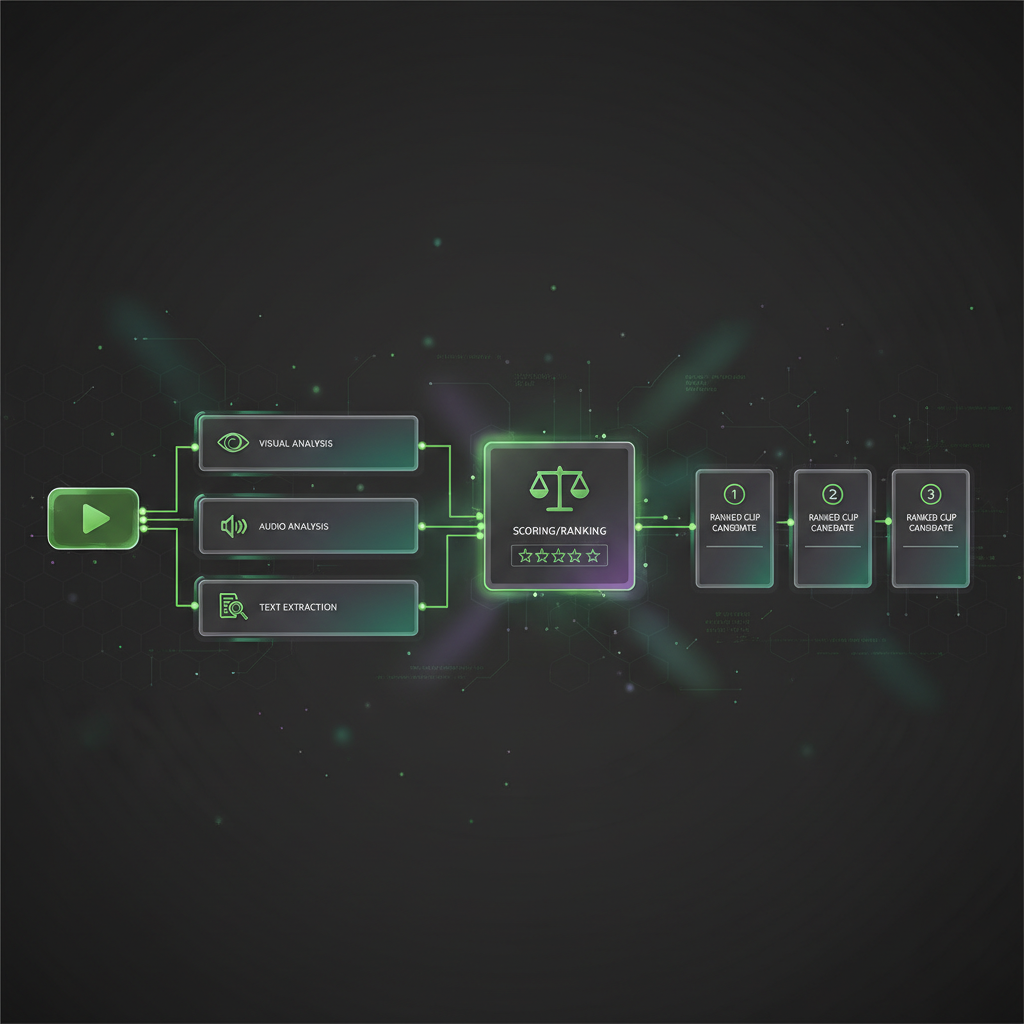
Un système de découpage vidéo par IA multimodal traite plusieurs flux de données simultanément : les images visuelles, le signal audio et la transcription. Chaque flux fournit des informations différentes, et le système les combine pour prendre des décisions qu'aucun flux seul ne pourrait soutenir.
Analyse visuelle
La piste visuelle est traitée par des modèles de vision par ordinateur qui détectent et suivent plusieurs éléments :
- Changements de scène. Les coupes franches, les fondus enchaînés et les changements significatifs dans la composition visuelle signalent des transitions entre les sujets ou les segments.
- Détection et suivi des visages. Le modèle identifie qui parle, ses expressions faciales et son état émotionnel. Un sourcil levé, un sourire qui apparaît ou un air de surprise sont tous porteurs de sens.
- Mouvement et énergie. Les gestes rapides, le fait de se pencher en avant ou de se lever indiquent des moments d'emphase. Les images statiques et à faible énergie correspondent souvent à du remplissage.
- Éléments à l'écran. Les superpositions de texte, les diapositives, les plans de produits ou les partages d'écran peuvent indiquer des segments structurés qui méritent d'être conservés comme clips autonomes.
Analyse audio
Au-delà de la transcription, le signal audio lui-même contient de riches informations :
- Énergie vocale et hauteur. Une hauteur de voix croissante et un volume accru signalent l'excitation ou l'emphase. Ces moments sont fortement corrélés à l'engagement du spectateur.
- Rires et réactions. Les rires du public, les halètements ou les applaudissements sont de puissants marqueurs de clips que les outils basés uniquement sur la transcription manquent complètement.
- Silence et pauses. Les pauses stratégiques précèdent ou suivent souvent des déclarations importantes. Elles servent également de points de coupe naturels.
- Musique et design sonore. Les changements de musique de fond, les effets sonores ou les jingles d'intro/outro aident l'IA à identifier les limites structurelles dans le contenu produit.
Combinaison des signaux
La véritable puissance émerge lorsque ces flux sont fusionnés. Imaginez un podcast où l'hôte dit quelque chose de légèrement intéressant — la transcription seule pourrait ne pas le signaler. Mais si les yeux de l'invité s'écarquillent, qu'il se penche en avant, que sa voix monte en hauteur et qu'il interrompt avec "Attendez, répétez ça" — le système multimodal reconnaît cela comme un moment de fort engagement car chaque signal converge.
C'est ainsi que fonctionne l'IA de ClipMaster. Elle ne se contente pas de lire ce qui a été dit — elle regarde et écoute pour comprendre comment les choses ont été dites et comment les gens ont réagi. Le résultat est des clips qui capturent de véritables moments d'énergie, et pas seulement des passages de texte thématiquement pertinents.
Notation et classement des clips
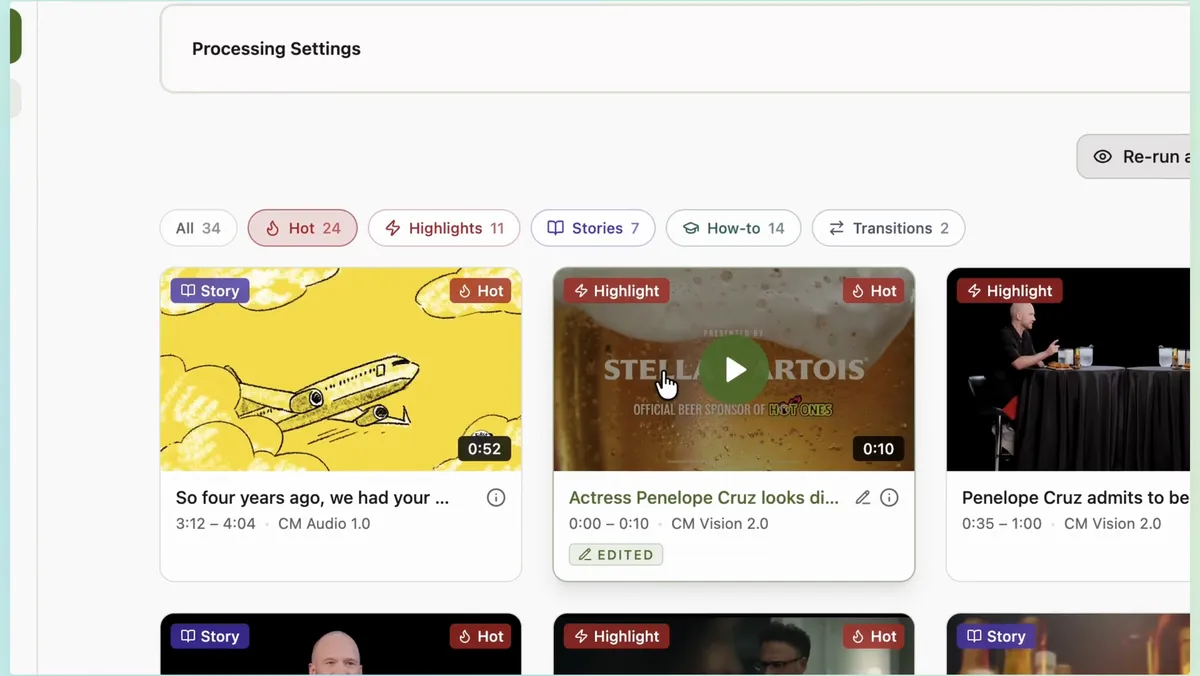
Une fois que l'IA a traité les trois flux, elle génère un ensemble de clips candidats et attribue un score à chacun. Le modèle de notation prend en compte plusieurs facteurs :
- Potentiel d'engagement. Quelle est la probabilité que ce clip retienne l'attention d'un spectateur du début à la fin ? Les clips avec des débuts percutants et des résolutions claires obtiennent un score plus élevé.
- Cohérence autonome. Le clip a-t-il un sens sans contexte supplémentaire ? Un moment qui nécessite cinq minutes de préparation pour être compris obtient un score inférieur à un moment qui s'explique de lui-même.
- Arc émotionnel. Les meilleurs clips courts ont une micro-narration — une introduction, un point culminant et une résolution. L'IA recherche cet arc dans chaque segment candidat.
- Qualité technique. Les clips où l'orateur est clairement visible, l'audio est propre et le cadrage est stable obtiennent un score plus élevé que les clips de mauvaise qualité de production.
Le résultat est une liste classée de clips, généralement triés par score d'engagement. Le créateur les examine, apporte des ajustements et exporte ceux qui conviennent.
Recherche vidéo sémantique : trouver des moments par leur signification
L'une des capacités les plus puissantes qui émerge de l'analyse multimodale est la recherche sémantique. Au lieu de rechercher des mots exacts dans une transcription, la recherche sémantique vous permet de décrire ce que vous cherchez en langage naturel, et l'IA trouve les moments correspondants — même si ces mots exacts n'ont jamais été prononcés.
Par exemple, rechercher "moment où l'invité n'est pas d'accord" trouvera des clips où le désaccord est exprimé par le langage corporel, le ton et les mots — et pas seulement des clips contenant le mot "désaccord". C'est fondamentalement différent de la recherche par mots-clés et considérablement plus rapide que de parcourir manuellement les séquences.
Pourquoi c'est important pour les créateurs
Le passage du découpage par IA basé uniquement sur la transcription au découpage multimodal n'est pas seulement une amélioration technique — il modifie les types de contenu qui peuvent être efficacement découpés.
- Le contenu visuel devient découpable. Les démonstrations de cuisine, les critiques de produits, les tutoriels de fitness et les vlogs de voyage reposent tous fortement sur les visuels. Les outils basés uniquement sur la transcription ont du mal avec ceux-ci. Les outils multimodaux les gèrent naturellement.
- Les moments émotionnels sont capturés. Les moments les plus drôles, les plus touchants, les plus surprenants d'une vidéo sont définis par l'émotion, pas par les mots. L'analyse multimodale saisit ce que l'analyse textuelle ne peut pas.
- Le montage semble humain. Parce que l'IA utilise les mêmes signaux qu'un monteur humain — expression, énergie, rythme — les clips résultants donnent l'impression d'avoir été coupés par quelqu'un qui a réellement regardé la vidéo.
La voie à suivre
Le découpage vidéo par IA s'améliore rapidement. Les modèles sont de plus en plus performants pour comprendre le contexte, l'humour, la structure narrative et les préférences du public. La prochaine frontière est la personnalisation — une IA qui apprend quels types de clips fonctionnent le mieux pour votre public spécifique et ajuste ses sélections en conséquence.
Mais le principe fondamental restera le même : plus l'IA comprend ce qu'elle regarde, meilleures seront ses décisions de montage. L'analyse multimodale n'est pas une fonctionnalité — c'est le fondement qui sépare les outils vidéo d'apprentissage automatique qui produisent des clips utilisables de ceux qui produisent des montages bruts. Si vous évaluez des outils de découpage par IA, la première question à poser est simple : regarde-t-il réellement la vidéo, ou se contente-t-il de lire la transcription ?