AI वीडियो क्लिपिंग कैसे काम करती है और यह क्यों मायने रखती है
AI वीडियो क्लिपिंग दो साल से भी कम समय में एक नई चीज़ से एक प्रोडक्शन टूल बन गई है। जो काम पहले एक इंसान एडिटर को घंटों फुटेज देखकर, पेसिंग और इमोशन के बारे में निर्णय लेकर करना पड़ता था, वह अब मशीन लर्निंग मॉडल मिनटों में कर सकते हैं। लेकिन यह असल में काम कैसे करता है? और कुछ टूल ऐसे क्लिप क्यों बनाते हैं जो नेचुरल लगते हैं जबकि दूसरे वीडियो को अजीब, बेतरतीब जगहों पर काट देते हैं?
इसका जवाब इस बात में छिपा है कि AI असल में क्या एनालाइज कर रहा है। सभी ऑटोमेटिक वीडियो एडिटिंग टूल एक जैसे नहीं होते, और एक साधारण टूल और एक बेहतरीन टूल के बीच का अंतर एक ही आर्किटेक्चरल निर्णय पर निर्भर करता है: क्या सिस्टम केवल ट्रांसक्रिप्ट देखता है, या पूरे ऑडियोविजुअल सिग्नल को देखता है।
केवल-ट्रांसक्रिप्ट अप्रोच
अधिकांश पहली पीढ़ी के AI क्लिपिंग टूल इस तरह काम करते हैं: वे स्पीच-टू-टेक्स्ट का उपयोग करके ऑडियो को ट्रांसक्राइब करते हैं, ट्रांसक्रिप्ट को एक लैंग्वेज मॉडल के माध्यम से चलाते हैं, और उसे "दिलचस्प" सेगमेंट की पहचान करने के लिए कहते हैं। मॉडल उन वाक्यों को चुनता है जो महत्वपूर्ण लगते हैं, उन्हें टाइमस्टैम्प से मैप करता है, और उन बिंदुओं पर वीडियो को काटता है।
यह अप्रोच तेज़ और बनाने में सस्ता है। यह मौजूदा बड़े लैंग्वेज मॉडल का लाभ उठाता है जो टेक्स्ट को समझने में बहुत अच्छे हैं। कुछ प्रकार की सामग्री के लिए — जैसे स्पष्ट मौखिक निष्कर्ष वाले इंटरव्यू — यह यथोचित रूप से अच्छी तरह से काम करता है।
लेकिन इसमें मौलिक कमियाँ हैं:
- यह देख नहीं सकता। केवल-विजुअल क्षण — एक प्रोडक्ट डेमो, एक रिएक्शन शॉट, एक नाटकीय खुलासा — एक ट्रांसक्रिप्ट-आधारित सिस्टम के लिए अदृश्य होते हैं।
- यह टोन और एनर्जी को मिस करता है। "यह अविश्वसनीय है" शब्द को वास्तविक उत्साह या बेजान व्यंग्य के साथ बोला जा सकता है। ट्रांसक्रिप्ट दोनों तरह से समान दिखता है।
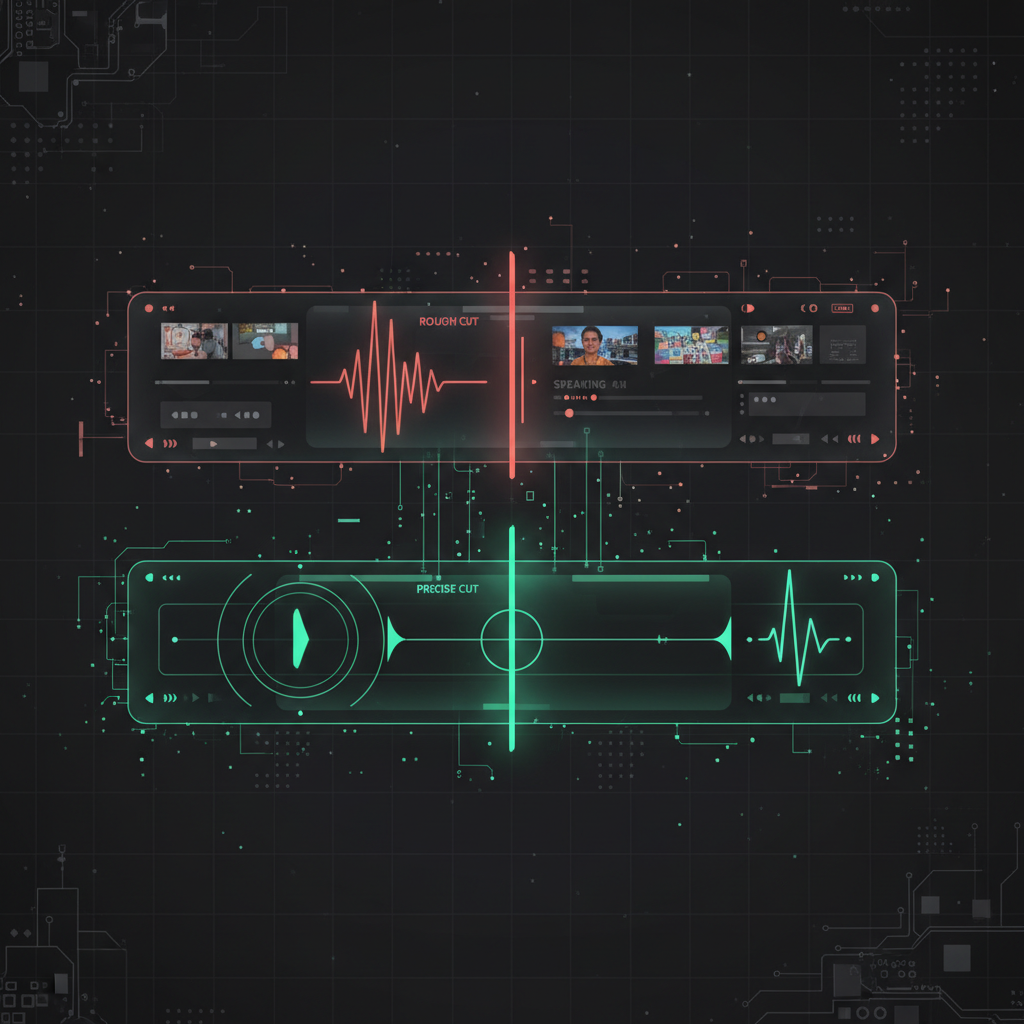
- यह वाक्य सीमाओं पर काटता है। नेचुरल क्लिप पॉइंट शायद ही कभी वाक्य के अंत के साथ संरेखित होते हैं। एक बेहतरीन क्लिप एक रिएक्शन के साथ वाक्य के बीच में शुरू हो सकती है और एक विजुअल बीट पर समाप्त हो सकती है।
- यह पेसिंग को अनदेखा करता है। एक बातचीत की लय — ठहराव, हँसी, ओवरलैपिंग स्पीच — भावनात्मक जानकारी रखती है जिसे केवल टेक्स्ट कैप्चर नहीं कर सकता।
केवल-ट्रांसक्रिप्ट टूल ऐसे क्लिप बनाते हैं जो विषयगत रूप से प्रासंगिक होते हैं लेकिन अक्सर ऐसा महसूस होता है जैसे किसी ने कैंची से बातचीत को बेतरतीब बिंदुओं पर काट दिया हो। सामग्री सही है, लेकिन टाइमिंग गलत है।
मल्टीमॉडल अप्रोच: विजुअल + ऑडियो विश्लेषण
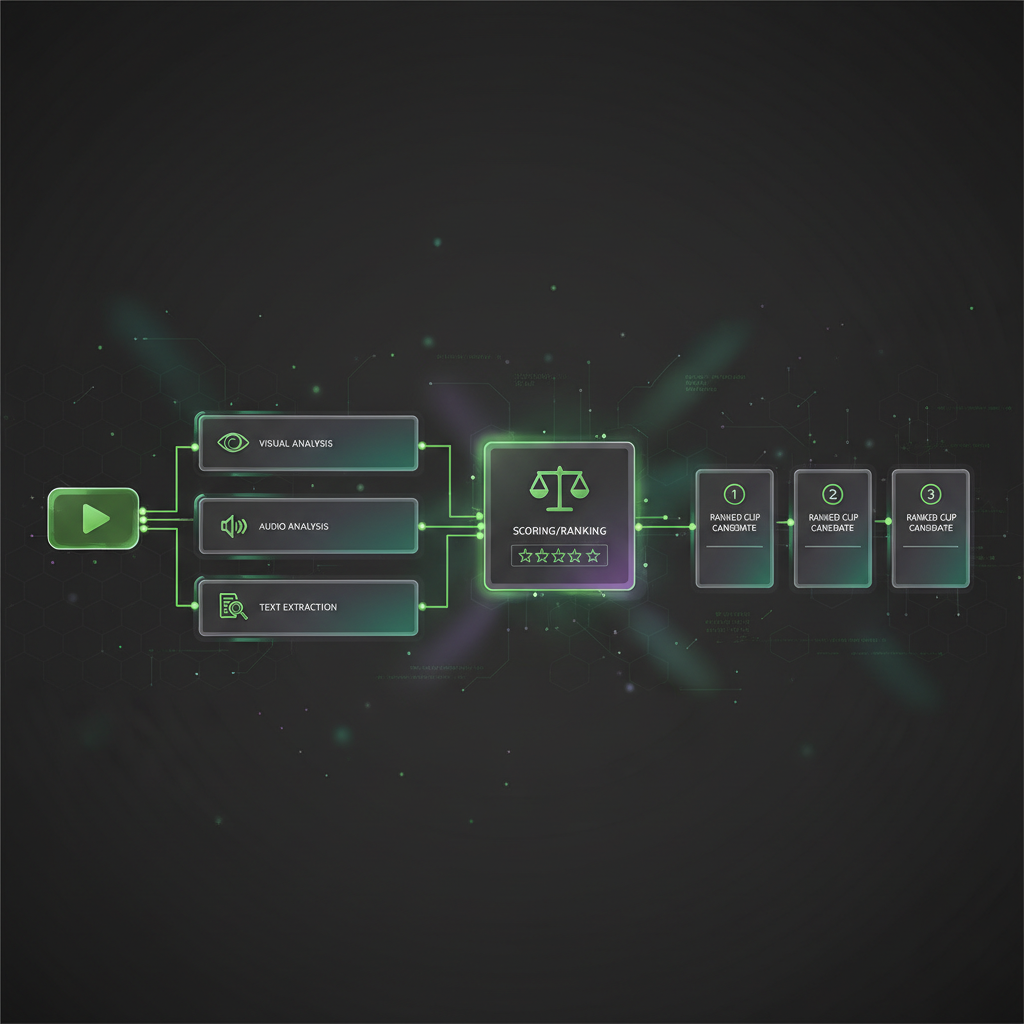
एक मल्टीमॉडल AI वीडियो क्लिपिंग सिस्टम एक साथ कई डेटा स्ट्रीम को प्रोसेस करता है: विजुअल फ्रेम्स, ऑडियो सिग्नल, और ट्रांसक्रिप्ट। प्रत्येक स्ट्रीम अलग-अलग जानकारी प्रदान करती है, और सिस्टम उन निर्णयों को लेने के लिए उन्हें जोड़ता है जिन्हें कोई भी एक स्ट्रीम अपने दम पर सपोर्ट नहीं कर सकती थी।
विजुअल विश्लेषण
विजुअल ट्रैक को कंप्यूटर विजन मॉडल द्वारा प्रोसेस किया जाता है जो कई तत्वों का पता लगाते और ट्रैक करते हैं:
- सीन में बदलाव। हार्ड कट, डिसॉल्व, और विजुअल कंपोजिशन में महत्वपूर्ण बदलाव विषयों या सेगमेंट के बीच ट्रांजिशन का संकेत देते हैं।
- चेहरे का पता लगाना और ट्रैक करना। मॉडल पहचानता है कि कौन बोल रहा है, उनके चेहरे के भाव, और उनकी भावनात्मक स्थिति। एक उठी हुई भौंह, एक मुस्कान जो टूट रही है, या आश्चर्य का भाव सभी का अर्थ होता है।
- गति और ऊर्जा। तेज़ हावभाव, आगे झुकना, या खड़े होना जोर के क्षणों को इंगित करता है। स्थिर, कम-ऊर्जा वाले फ्रेम्स अक्सर फिलर के अनुरूप होते हैं।
- ऑन-स्क्रीन तत्व। टेक्स्ट ओवरले, स्लाइड, प्रोडक्ट शॉट, या स्क्रीन शेयर संरचित सेगमेंट को इंगित कर सकते हैं जिन्हें स्टैंडअलोन क्लिप के रूप में संरक्षित किया जाना चाहिए।
ऑडियो विश्लेषण
ट्रांसक्रिप्शन से परे, ऑडियो सिग्नल में ही समृद्ध जानकारी होती है:
- वोकल एनर्जी और पिच। बढ़ती पिच और बढ़ी हुई वॉल्यूम उत्साह या जोर का संकेत देती है। ये क्षण दर्शक जुड़ाव के साथ दृढ़ता से सहसंबंधित होते हैं।
- हँसी और प्रतिक्रियाएँ। दर्शकों की हँसी, आहें, या तालियाँ शक्तिशाली क्लिप मार्कर होते हैं जिन्हें केवल-ट्रांसक्रिप्ट टूल पूरी तरह से मिस कर देते हैं।
- खामोशी और ठहराव। रणनीतिक ठहराव अक्सर महत्वपूर्ण बयानों से पहले या बाद में आते हैं। वे नेचुरल कट पॉइंट के रूप में भी काम करते हैं।
- संगीत और साउंड डिज़ाइन। बैकग्राउंड म्यूजिक में बदलाव, साउंड इफ़ेक्ट, या इंट्रो/आउट्रो जिंगल AI को उत्पादित सामग्री में संरचनात्मक सीमाओं की पहचान करने में मदद करते हैं।
सिग्नल को जोड़ना
जब इन स्ट्रीम को फ्यूज किया जाता है तो वास्तविक शक्ति उभरती है। एक पॉडकास्ट पर विचार करें जहाँ होस्ट कुछ हल्का दिलचस्प कहता है — केवल ट्रांसक्रिप्ट इसे फ्लैग नहीं कर सकता है। लेकिन अगर मेहमान की आँखें चौड़ी हो जाती हैं, वे आगे झुकते हैं, उनकी आवाज की पिच बढ़ जाती है, और वे "रुको, फिर से कहो" के साथ बाधित करते हैं — मल्टीमॉडल सिस्टम इसे एक उच्च-जुड़ाव वाले क्षण के रूप में पहचानता है क्योंकि हर सिग्नल अभिसरण कर रहा है।
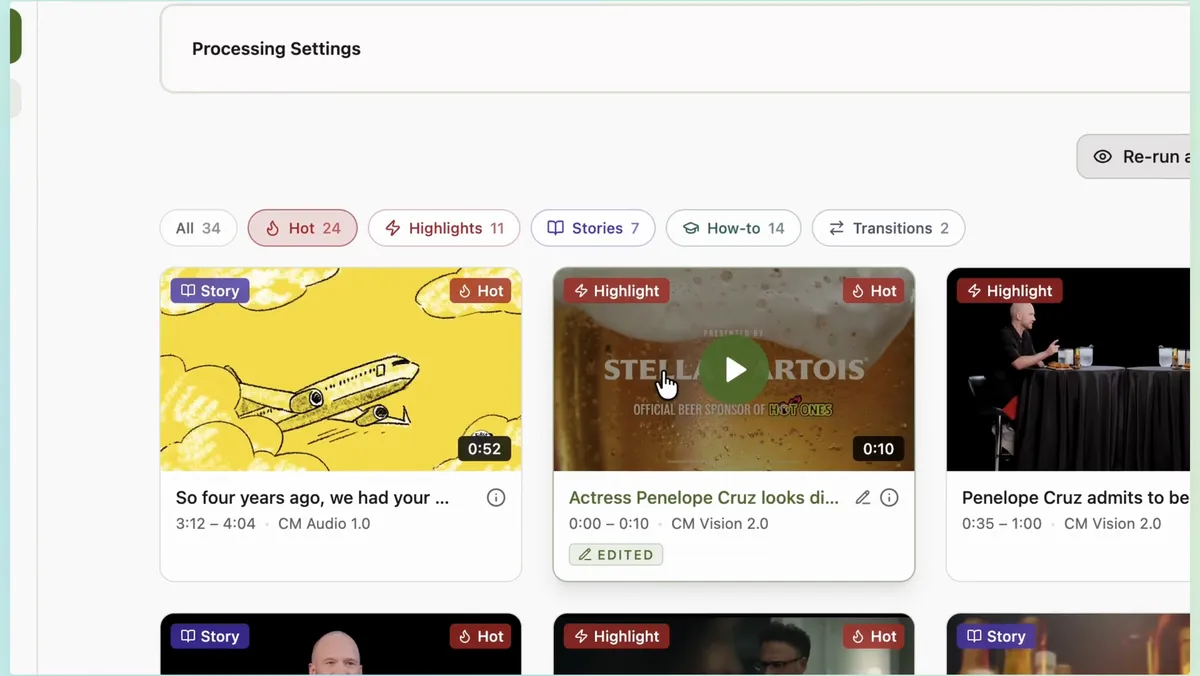
ClipMaster का AI इसी तरह काम करता है। यह केवल यह नहीं पढ़ता कि क्या कहा गया था — यह देखता और सुनता है कि चीजें कैसे कही गईं और लोगों ने कैसे प्रतिक्रिया दी। इसका परिणाम ऐसे क्लिप होते हैं जो एनर्जी के वास्तविक क्षणों को कैप्चर करते हैं, न कि केवल विषयगत रूप से प्रासंगिक टेक्स्ट पैसेज को।
क्लिप को स्कोर करना और रैंक करना
एक बार जब AI सभी तीन स्ट्रीम को प्रोसेस कर लेता है, तो यह उम्मीदवार क्लिप का एक सेट जेनरेट करता है और प्रत्येक को स्कोर करता है। स्कोरिंग मॉडल कई कारकों पर विचार करता है:
- जुड़ाव की क्षमता। इस क्लिप के शुरू से अंत तक दर्शक का ध्यान आकर्षित करने की कितनी संभावना है? मजबूत ओपनिंग और स्पष्ट समाधान वाले क्लिप को उच्च स्कोर मिलता है।
- स्टैंडअलोन सुसंगतता। क्या क्लिप अतिरिक्त संदर्भ के बिना समझ में आता है? एक क्षण जिसे समझने के लिए पाँच मिनट की तैयारी की आवश्यकता होती है, उसे एक स्व-व्याख्यात्मक क्षण की तुलना में कम स्कोर मिलता है।
- भावनात्मक चाप। सबसे अच्छी छोटी क्लिप में एक सूक्ष्म-कथा होती है — एक सेटअप, एक शिखर, और एक समाधान। AI प्रत्येक उम्मीदवार सेगमेंट में इस चाप की तलाश करता है।
- तकनीकी गुणवत्ता। जिन क्लिप में स्पीकर स्पष्ट रूप से दिखाई देता है, ऑडियो साफ है, और फ्रेमिंग स्थिर है, उन्हें खराब उत्पादन गुणवत्ता वाले क्लिप की तुलना में उच्च स्कोर मिलता है।
आउटपुट क्लिप की एक रैंक की गई सूची होती है, जिसे आमतौर पर जुड़ाव स्कोर द्वारा सॉर्ट किया जाता है। क्रिएटर उनकी समीक्षा करता है, समायोजन करता है, और जो काम करते हैं उन्हें एक्सपोर्ट करता है।
सिमेंटिक वीडियो सर्च: अर्थ के अनुसार क्षणों को खोजना
मल्टीमॉडल विश्लेषण से उभरने वाली सबसे शक्तिशाली क्षमताओं में से एक सिमेंटिक सर्च है। ट्रांसक्रिप्ट में सटीक शब्दों की खोज करने के बजाय, सिमेंटिक सर्च आपको प्राकृतिक भाषा में यह वर्णन करने देती है कि आप क्या खोज रहे हैं, और AI मिलान करने वाले क्षणों को ढूंढता है — भले ही वे सटीक शब्द कभी बोले न गए हों।
उदाहरण के लिए, "वह क्षण जहाँ मेहमान असहमत होता है" खोजने से ऐसे क्लिप मिलेंगे जहाँ असहमति बॉडी लैंग्वेज, टोन, और शब्दों के माध्यम से व्यक्त की जाती है — न कि केवल "असहमत" शब्द वाले क्लिप। यह कीवर्ड सर्च से मौलिक रूप से अलग है और फुटेज को मैन्युअल रूप से स्क्रॉल करने की तुलना में नाटकीय रूप से तेज़ है।
यह क्रिएटर्स के लिए क्यों मायने रखता है
केवल-ट्रांसक्रिप्ट से मल्टीमॉडल AI क्लिपिंग में बदलाव सिर्फ एक तकनीकी सुधार नहीं है — यह बदलता है कि किस प्रकार की सामग्री को प्रभावी ढंग से क्लिप किया जा सकता है।
- विजुअल सामग्री क्लिप करने योग्य हो जाती है। कुकिंग डेमो, प्रोडक्ट रिव्यू, फिटनेस ट्यूटोरियल, और ट्रैवल व्लॉग सभी विजुअल्स पर बहुत अधिक निर्भर करते हैं। केवल-ट्रांसक्रिप्ट टूल इनके साथ संघर्ष करते हैं। मल्टीमॉडल टूल इन्हें स्वाभाविक रूप से संभालते हैं।
- भावनात्मक क्षण कैप्चर होते हैं। एक वीडियो में सबसे मज़ेदार, सबसे मार्मिक, सबसे आश्चर्यजनक क्षण भावनाओं से परिभाषित होते हैं, शब्दों से नहीं। मल्टीमॉडल विश्लेषण वह पकड़ता है जो टेक्स्ट विश्लेषण नहीं कर सकता।
- एडिटिंग मानवीय लगती है। क्योंकि AI उन्हीं संकेतों का उपयोग कर रहा है जो एक मानवीय एडिटर करेगा — अभिव्यक्ति, ऊर्जा, पेसिंग — परिणामी क्लिप ऐसा महसूस होता है जैसे उन्हें किसी ऐसे व्यक्ति ने काटा हो जिसने वास्तव में वीडियो देखा हो।
आगे का रास्ता
AI वीडियो क्लिपिंग तेजी से सुधर रही है। मॉडल संदर्भ, हास्य, कथा संरचना, और दर्शकों की प्राथमिकताओं को समझने में बेहतर हो रहे हैं। अगली सीमा पर्सनलाइजेशन है — AI जो सीखता है कि आपकी विशिष्ट ऑडियंस के लिए किस प्रकार के क्लिप सबसे अच्छा प्रदर्शन करते हैं और तदनुसार अपने चयन को समायोजित करता है।
लेकिन मूल सिद्धांत वही रहेगा: AI जितना अधिक समझेगा कि वह क्या देख रहा है, उसके एडिटिंग निर्णय उतने ही बेहतर होंगे। मल्टीमॉडल विश्लेषण एक फ़ीचर नहीं है — यह वह नींव है जो मशीन लर्निंग वीडियो टूल को अलग करती है जो उपयोगी क्लिप बनाते हैं उनसे जो रफ कट बनाते हैं। यदि आप AI क्लिपिंग टूल का मूल्यांकन कर रहे हैं, तो पूछने वाला पहला प्रश्न सरल है: क्या यह वास्तव में वीडियो देखता है, या यह केवल ट्रांसक्रिप्ट पढ़ता है?