Cara Kerja Klip Video AI dan Kenapa Itu Penting
Pemotongan klip video dengan AI berubah dari sekadar barang baru jadi alat produksi sungguhan dalam waktu kurang dari dua tahun. Pekerjaan yang dulu butuh editor manusia untuk menonton rekaman berjam-jam sambil menimbang tempo dan emosi, sekarang bisa dikerjakan model machine learning dalam hitungan menit. Tapi sebenarnya bagaimana cara kerjanya? Dan kenapa ada tool yang menghasilkan klip terasa alami, sementara yang lain memotong video di titik yang canggung dan tidak bermakna?
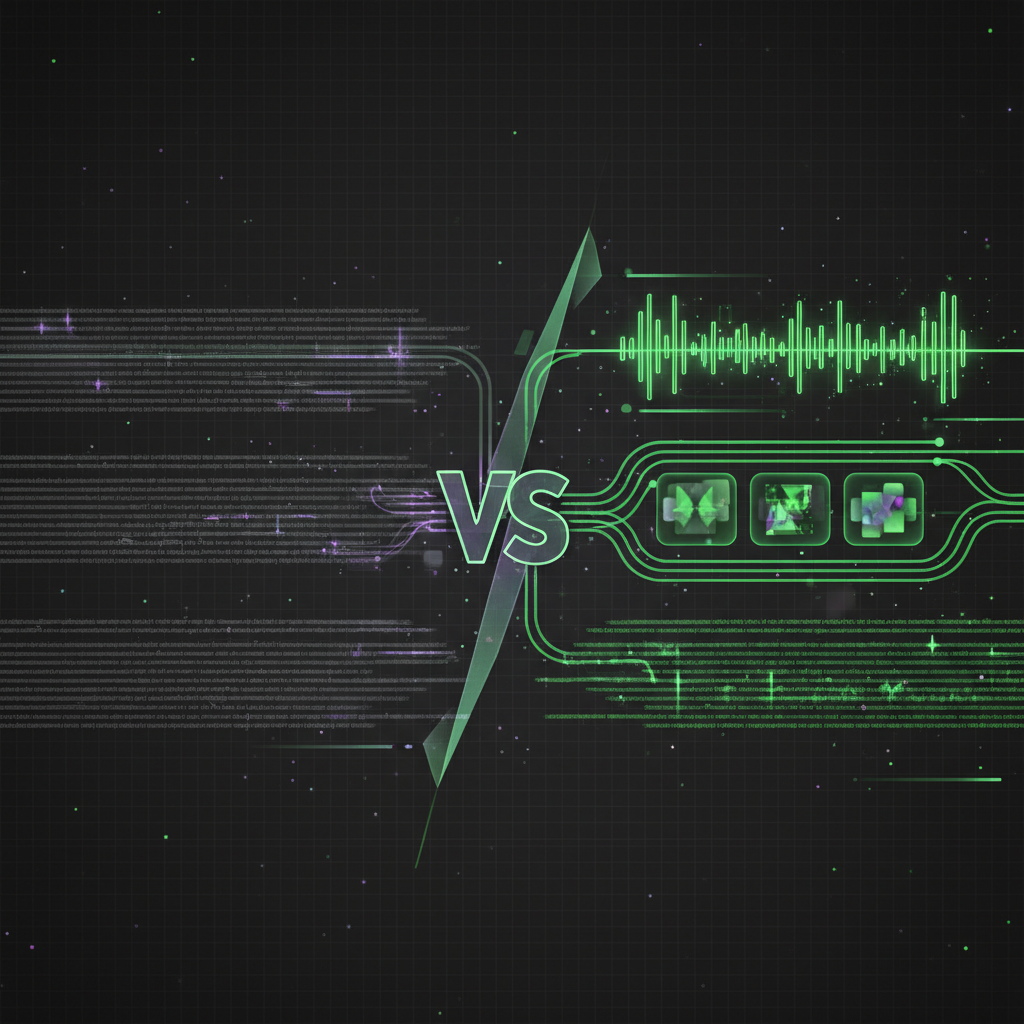
Jawabannya ada pada apa yang sebenarnya dianalisis oleh AI. Tidak semua tool edit video otomatis diciptakan sama, dan beda antara tool yang biasa-biasa saja dengan yang hebat bermuara pada satu keputusan arsitektur: apakah sistemnya hanya melihat transkrip, atau seluruh sinyal audiovisual.
Pendekatan yang hanya mengandalkan transkrip
Kebanyakan tool pemotong klip AI generasi pertama bekerja seperti ini: audio ditranskripsi dengan speech-to-text, transkripnya dijalankan lewat model bahasa, lalu model itu diminta menemukan segmen yang "menarik". Model memilih kalimat yang tampak penting, mencocokkannya kembali ke timestamp, lalu memotong video di titik-titik itu.
Pendekatan ini cepat dan murah untuk dibangun. Ia memanfaatkan model bahasa besar yang sudah ada dan sangat pintar memahami teks. Untuk sebagian jenis konten — misalnya wawancara dengan poin-poin verbal yang jelas — hasilnya lumayan.
Tapi pendekatan ini punya titik buta yang mendasar:
- Ia tidak bisa melihat. Momen yang murni visual — demo produk, shot reaksi, pengungkapan yang dramatis — sama sekali tak terlihat oleh sistem berbasis transkrip.
- Ia melewatkan nada dan energi. Kata-kata "itu luar biasa" bisa diucapkan dengan antusias sungguhan atau dengan sarkasme datar. Di transkrip, keduanya terlihat sama persis.
- Ia memotong di batas kalimat. Titik potong yang alami jarang pas dengan akhir kalimat. Klip yang bagus bisa dimulai di tengah kalimat dengan sebuah reaksi dan berakhir di sebuah momen visual.
- Ia mengabaikan tempo. Ritme percakapan — jeda, tawa, omongan yang saling tumpang tindih — membawa informasi emosional yang tidak bisa ditangkap oleh teks saja.
Tool yang hanya mengandalkan transkrip menghasilkan klip yang topiknya relevan, tapi sering terasa seperti percakapan yang digunting di titik acak. Isinya benar, tapi timing-nya meleset.
Pendekatan multimodal: analisis visual + audio
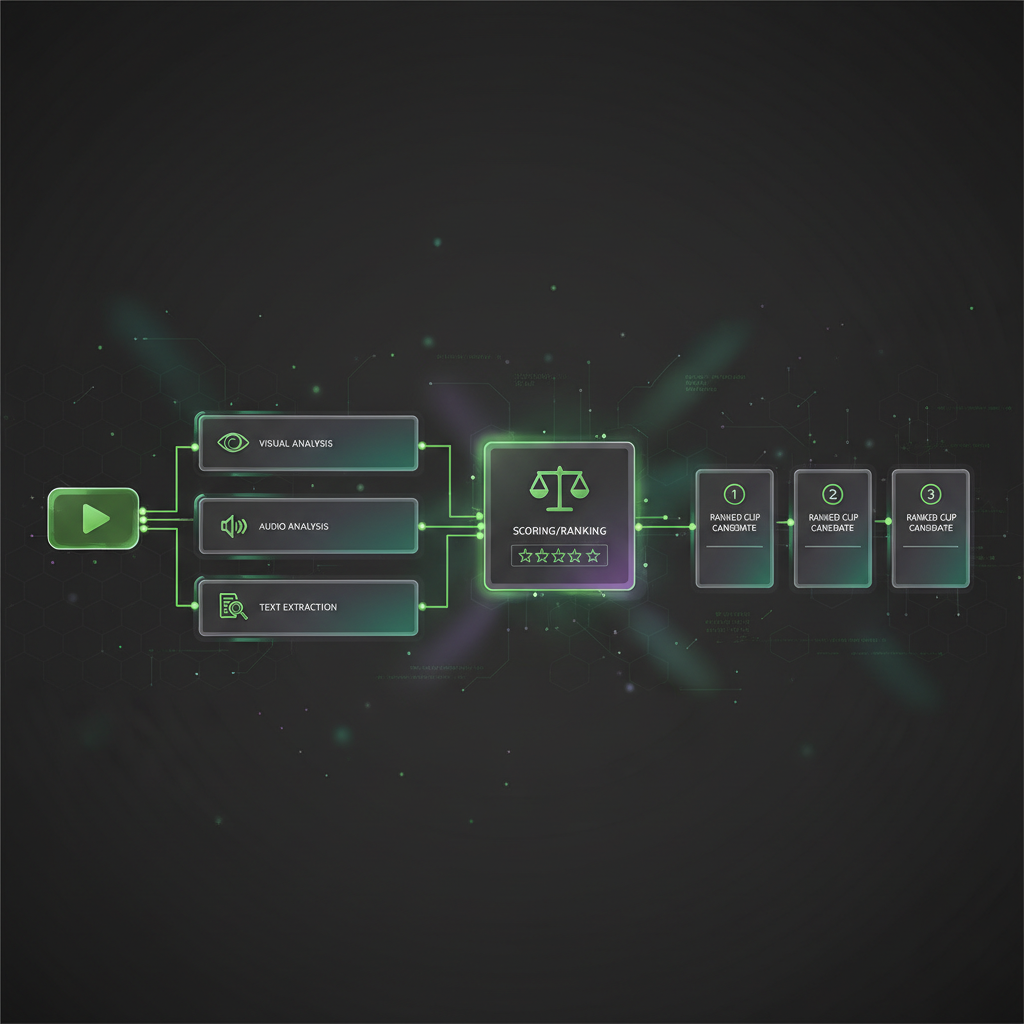
Sistem pemotong klip video AI yang multimodal memproses beberapa aliran data sekaligus: frame visual, sinyal audio, dan transkrip. Setiap aliran memberi informasi yang berbeda, dan sistem menggabungkan semuanya untuk mengambil keputusan yang tidak mungkin didukung oleh satu aliran saja.
Analisis visual
Jalur visual diproses oleh model computer vision yang mendeteksi dan melacak beberapa elemen:
- Pergantian adegan. Hard cut, dissolve, dan perubahan komposisi visual yang signifikan menandakan transisi antartopik atau antarsegmen.
- Deteksi dan pelacakan wajah. Model mengenali siapa yang sedang bicara, ekspresi wajahnya, dan kondisi emosionalnya. Alis yang terangkat, senyum yang pecah, atau raut kaget — semuanya punya makna.
- Gerakan dan energi. Gestur cepat, badan yang condong ke depan, atau tiba-tiba berdiri menandakan momen penekanan. Frame yang statis dan minim energi biasanya berarti bagian pengisi.
- Elemen di layar. Teks overlay, slide, shot produk, atau share screen bisa menandakan segmen terstruktur yang layak dipertahankan sebagai klip yang berdiri sendiri.
Analisis audio
Di luar transkripsi, sinyal audionya sendiri menyimpan banyak informasi:
- Energi dan nada suara. Nada yang naik dan volume yang meninggi menandakan antusiasme atau penekanan. Momen-momen ini sangat berkorelasi dengan engagement penonton.
- Tawa dan reaksi. Tawa penonton, suara terkesiap, atau tepuk tangan adalah penanda klip yang kuat — dan sama sekali terlewat oleh tool berbasis transkrip.
- Hening dan jeda. Jeda yang strategis sering muncul sebelum atau sesudah pernyataan penting. Jeda juga berfungsi sebagai titik potong yang alami.
- Musik dan sound design. Perubahan musik latar, efek suara, atau jingle intro/outro membantu AI mengenali batas-batas struktur di konten yang diproduksi.
Menggabungkan sinyal-sinyalnya
Kekuatan sebenarnya muncul saat aliran-aliran ini digabungkan. Bayangkan sebuah podcast di mana host mengatakan sesuatu yang cukup menarik — transkrip saja mungkin tidak akan menandainya. Tapi kalau mata sang tamu membelalak, badannya condong ke depan, nada suaranya melonjak, dan ia menyela dengan "Tunggu, coba ulangi" — sistem multimodal mengenalinya sebagai momen dengan engagement tinggi karena semua sinyal mengarah ke titik yang sama.
Begitulah cara kerja AI ClipMaster. Ia tidak cuma membaca apa yang diucapkan — ia menonton dan mendengarkan untuk memahami bagaimana sesuatu diucapkan dan bagaimana orang bereaksi. Hasilnya adalah klip yang menangkap momen penuh energi yang sungguhan, bukan sekadar potongan teks yang topiknya relevan.
Memberi skor dan memeringkat klip
Setelah AI memproses ketiga aliran itu, ia menghasilkan sekumpulan kandidat klip dan memberi skor pada masing-masing. Model penilaiannya mempertimbangkan beberapa faktor:
- Potensi engagement. Seberapa besar kemungkinan klip ini menahan perhatian penonton dari awal sampai akhir? Klip dengan pembuka yang kuat dan penutup yang jelas mendapat skor lebih tinggi.
- Bisa berdiri sendiri. Apakah klip itu masuk akal tanpa konteks tambahan? Momen yang butuh lima menit pengantar untuk dipahami mendapat skor lebih rendah daripada momen yang sudah jelas dengan sendirinya.
- Alur emosi. Klip pendek terbaik punya narasi mini — pengantar, puncak, dan penyelesaian. AI mencari alur ini di setiap kandidat segmen.
- Kualitas teknis. Klip yang pembicaranya terlihat jelas, audionya bersih, dan framing-nya stabil mendapat skor lebih tinggi daripada klip dengan kualitas produksi yang buruk.
Hasilnya adalah daftar klip yang sudah diperingkat, biasanya diurutkan berdasarkan skor engagement. Kreator meninjaunya, melakukan penyesuaian, lalu mengekspor yang cocok.
Pencarian video semantik: menemukan momen berdasarkan makna
Salah satu kemampuan paling ampuh yang lahir dari analisis multimodal adalah pencarian semantik. Alih-alih mencari kata yang persis sama di transkrip, pencarian semantik memungkinkan kamu menjelaskan apa yang kamu cari dengan bahasa sehari-hari, lalu AI menemukan momen yang cocok — bahkan kalau kata-kata persisnya tidak pernah diucapkan.
Misalnya, mencari "momen saat tamu tidak setuju" akan menemukan klip di mana ketidaksetujuan itu diekspresikan lewat bahasa tubuh, nada, dan kata-kata — bukan cuma klip yang mengandung kata "tidak setuju". Ini berbeda secara mendasar dari pencarian kata kunci, dan jauh lebih cepat daripada menggeser-geser rekaman secara manual.
Kenapa ini penting bagi kreator
Pergeseran dari pemotongan klip AI berbasis transkrip ke multimodal bukan sekadar peningkatan teknis — ini mengubah jenis konten apa saja yang bisa diklip dengan efektif.
- Konten visual jadi bisa diklip. Demo masak, review produk, tutorial fitness, dan vlog perjalanan sangat bergantung pada visual. Tool berbasis transkrip kesulitan menanganinya. Tool multimodal menanganinya dengan wajar.
- Momen emosional ikut tertangkap. Momen paling lucu, paling menyentuh, dan paling mengejutkan dalam sebuah video ditentukan oleh emosi, bukan kata-kata. Analisis multimodal menangkap apa yang tidak bisa ditangkap analisis teks.
- Editannya terasa manusiawi. Karena AI memakai sinyal yang sama dengan yang dipakai editor manusia — ekspresi, energi, tempo — klip yang dihasilkan terasa seperti dipotong oleh orang yang benar-benar menonton videonya.
Ke mana arahnya
Pemotongan klip video dengan AI berkembang pesat. Model-modelnya makin pintar memahami konteks, humor, struktur narasi, dan preferensi audiens. Batas berikutnya adalah personalisasi — AI yang mempelajari jenis klip apa yang paling perform untuk audiens spesifikmu, lalu menyesuaikan pilihannya.
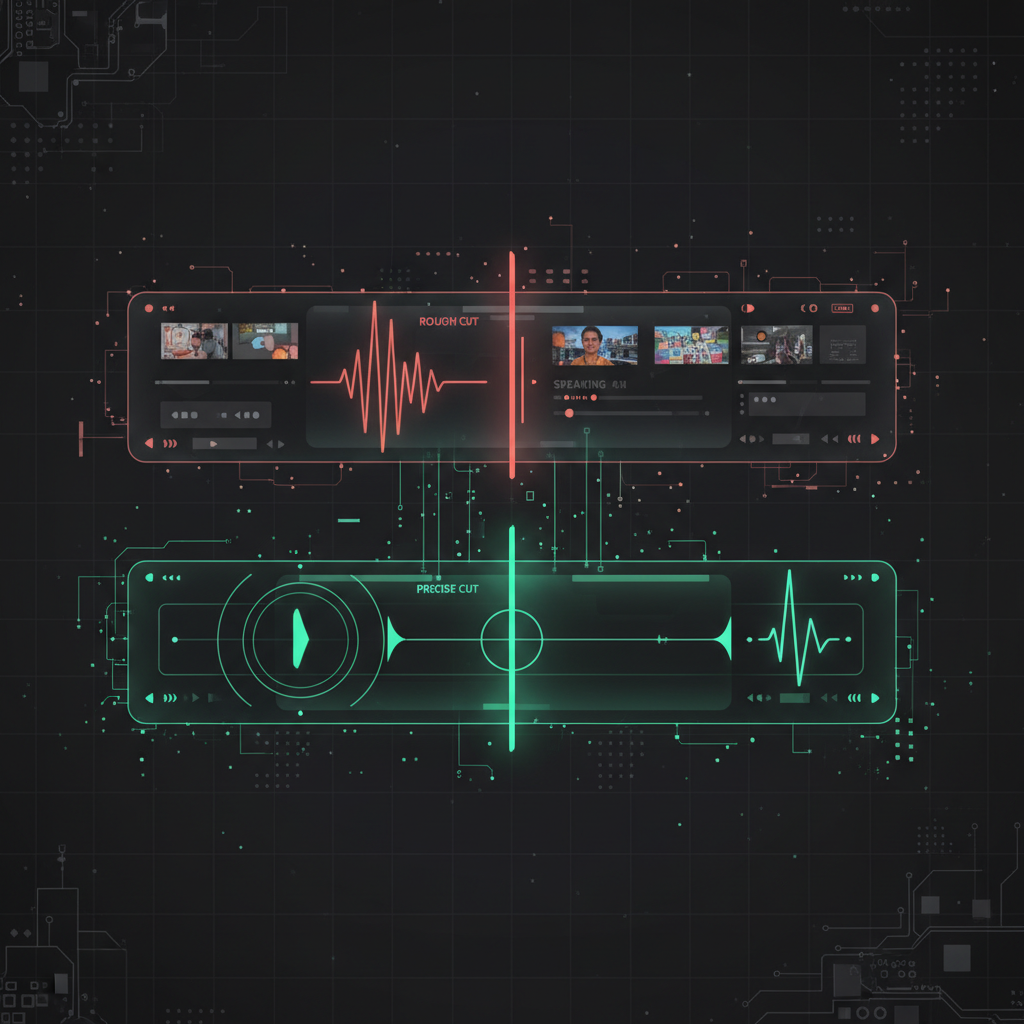
Tapi prinsip intinya akan tetap sama: makin banyak AI memahami apa yang ditontonnya, makin bagus keputusan editnya. Analisis multimodal bukan sekadar fitur — ia adalah fondasi yang memisahkan tool video machine learning yang menghasilkan klip siap pakai dari yang cuma menghasilkan potongan kasar. Kalau kamu sedang menimbang-nimbang tool pemotong klip AI, pertanyaan pertama yang perlu diajukan sederhana saja: apakah ia benar-benar menonton videonya, atau cuma membaca transkripnya?