Як працює AI-нарізка відео та чому це важливо
Штучний інтелект для нарізки відео менш ніж за два роки перетворився з новинки на повноцінний виробничий інструмент. Те, що раніше вимагало від людини-редактора годин перегляду матеріалу та прийняття рішень щодо темпу та емоцій, тепер може бути виконано моделями машинного навчання за лічені хвилини. Але як це насправді працює? І чому одні інструменти створюють кліпи, які виглядають природно, тоді як інші ріжуть відео у незручних, безглуздих місцях?
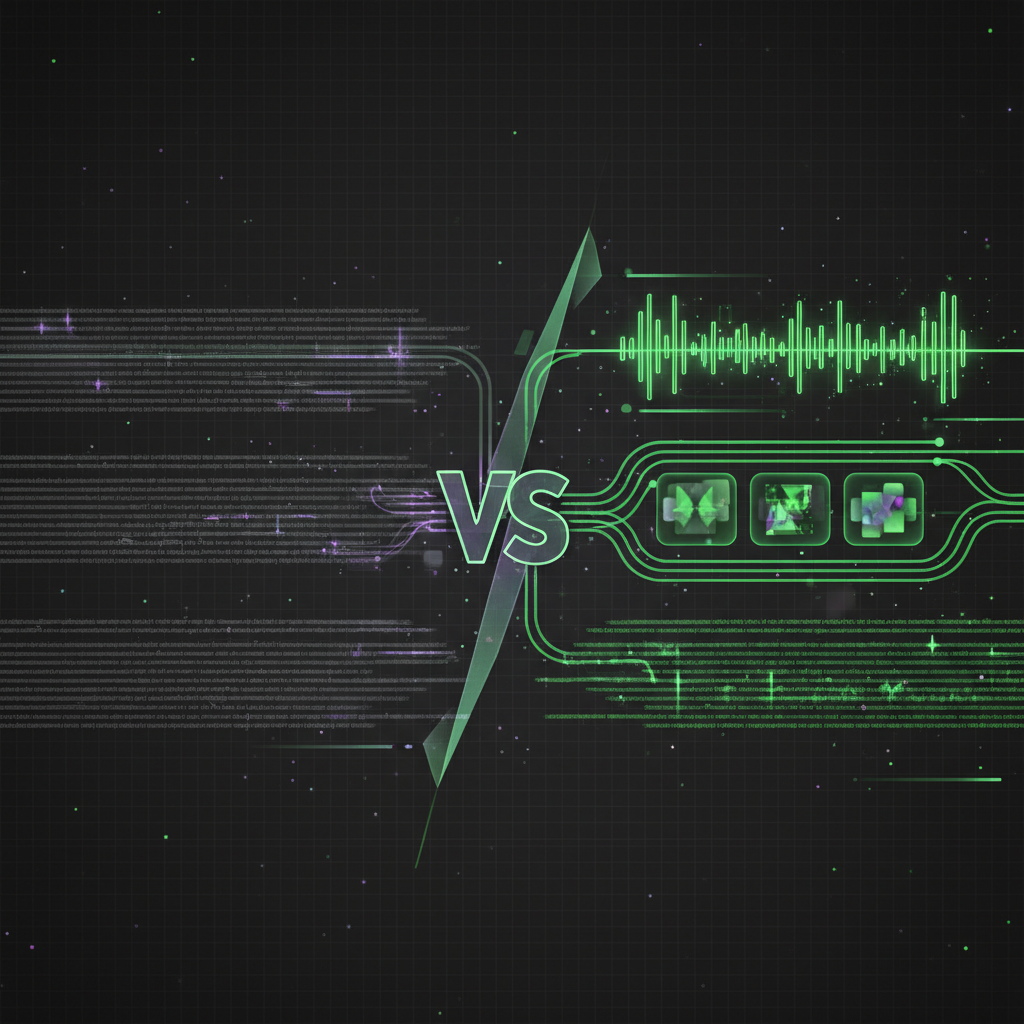
Відповідь криється в тому, що саме аналізує ШІ. Не всі інструменти автоматичного редагування відео однаково ефективні, і різниця між посереднім та чудовим інструментом зводиться до одного архітектурного рішення: чи система аналізує лише транскрипт, чи повний аудіовізуальний сигнал.
Підхід, що базується лише на транскрипті
Більшість інструментів для нарізки відео першого покоління, що працюють на основі ШІ, діють так: вони транскрибують аудіо за допомогою перетворення мови в текст, пропускають транскрипт через мовну модель і просять її визначити «цікаві» сегменти. Модель вибирає речення, які здаються важливими, зіставляє їх з часовими мітками та вирізає відео в цих точках.
Цей підхід швидкий і дешевий у розробці. Він використовує наявні великі мовні моделі, які дуже добре розуміють текст. Для деяких типів контенту — наприклад, інтерв'ю з чіткими вербальними висновками — він працює досить добре.
Але він має фундаментальні недоліки:
- Він не бачить. Суто візуальні моменти — демонстрація продукту, реакція, драматичне розкриття — невидимі для системи, що базується на транскрипті.
- Він пропускає тон і енергію. Слова «це неймовірно» можуть бути вимовлені зі справжнім захопленням або саркастичним спокоєм. Транскрипт в обох випадках виглядає однаково.
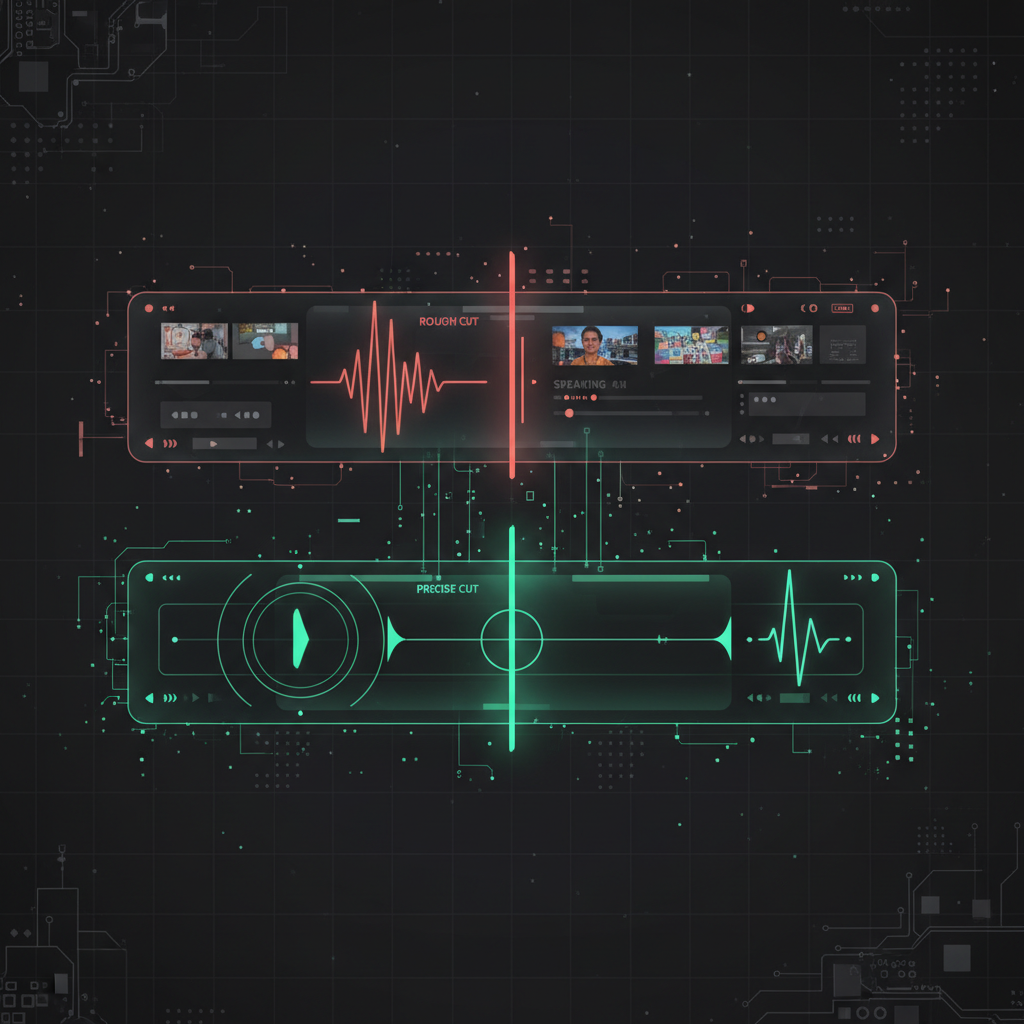
- Він ріже за межами речень. Природні точки для кліпів рідко збігаються з кінцями речень. Чудовий кліп може початися всередині речення з реакції та закінчитися на візуальному моменті.
- Він ігнорує темп. Ритм розмови — паузи, сміх, перекриття мови — несе емоційну інформацію, яку сам текст не може передати.
Інструменти, що базуються лише на транскрипті, створюють кліпи, які є тематично релевантними, але часто виглядають так, ніби хтось вирізав розмову ножицями у випадкових місцях. Зміст правильний, але час вибрано невдало.
Мультимодальний підхід: візуальний + аудіо аналіз
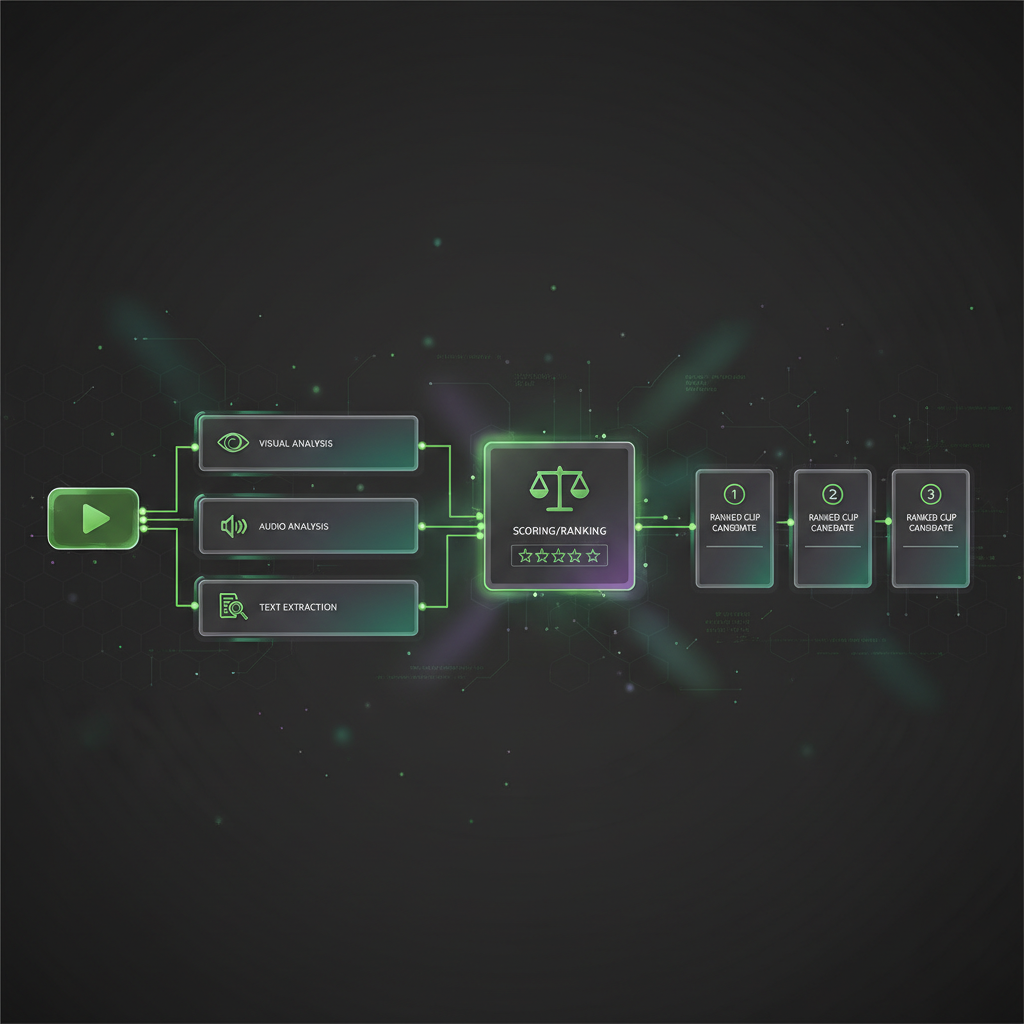
Мультимодальна система нарізки відео на основі ШІ обробляє кілька потоків даних одночасно: візуальні кадри, аудіосигнал і транскрипт. Кожен потік надає різну інформацію, і система поєднує їх для прийняття рішень, які жоден окремий потік не міг би підтримати самостійно.
Візуальний аналіз
Візуальна доріжка обробляється моделями комп'ютерного зору, які виявляють та відстежують кілька елементів:
- Зміни сцени. Різкі переходи, розчинення та значні зміни у візуальній композиції сигналізують про переходи між темами або сегментами.
- Виявлення та відстеження облич. Модель ідентифікує, хто говорить, їхні вирази обличчя та емоційний стан. Піднята брова, посмішка або здивований погляд — усе це несе значення.
- Рух та енергія. Швидкі жести, нахил вперед або вставання вказують на моменти акценту. Статичні, низькоенергетичні кадри часто відповідають заповнювачам.
- Елементи на екрані. Текстові накладки, слайди, знімки продуктів або спільний доступ до екрана можуть вказувати на структуровані сегменти, які варто зберегти як окремі кліпи.
Аудіо аналіз
Крім транскрипції, сам аудіосигнал містить багату інформацію:
- Вокальна енергія та висота. Зростання висоти та збільшення гучності сигналізують про збудження або акцент. Ці моменти сильно корелюють із залученістю глядачів.
- Сміх та реакції. Сміх аудиторії, подих або оплески є потужними маркерами кліпів, які інструменти, що базуються лише на транскрипті, повністю пропускають.
- Тиша та паузи. Стратегічні паузи часто передують або слідують за важливими твердженнями. Вони також слугують природними точками для вирізання.
- Музика та звуковий дизайн. Зміни фонової музики, звукові ефекти або вступні/заключні джингли допомагають ШІ ідентифікувати структурні межі у створеному контенті.
Поєднання сигналів
Справжня сила проявляється, коли ці потоки об'єднуються. Розглянемо подкаст, де ведучий говорить щось помірно цікаве — сам транскрипт може цього не помітити. Але якщо очі гостя розширюються, він нахиляється вперед, його голос підвищується, і він перебиває словами «Зачекайте, повторіть це ще раз» — мультимодальна система розпізнає це як момент високої залученості, тому що кожен сигнал сходиться.
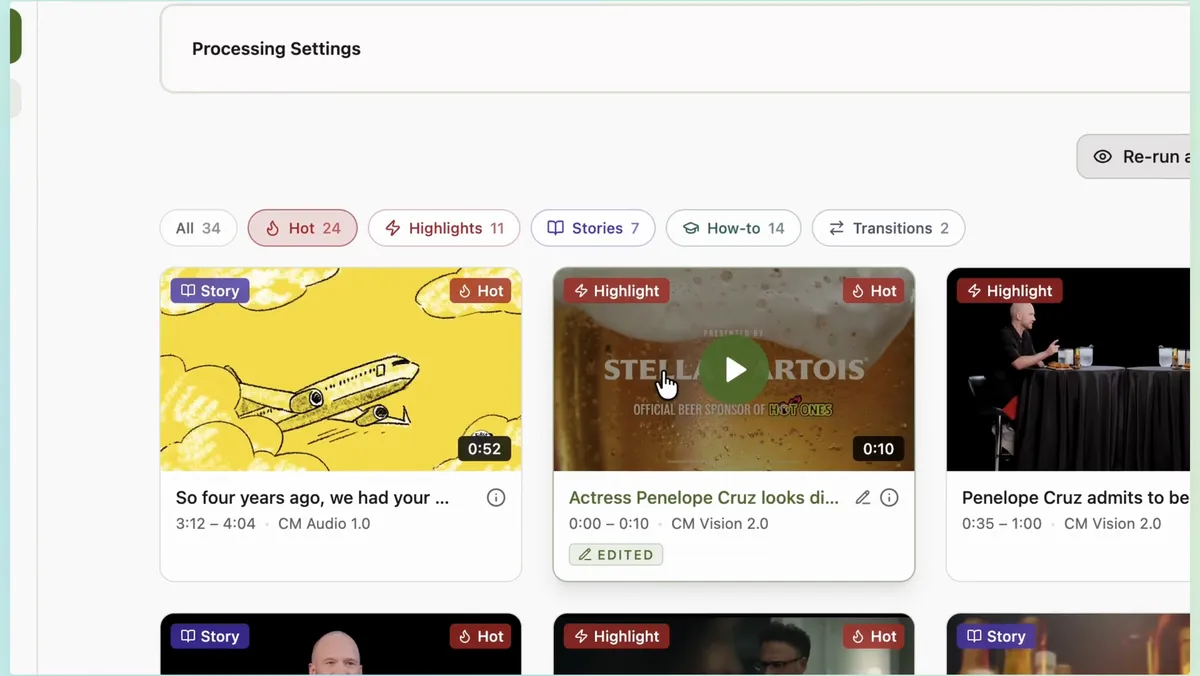
Саме так працює ШІ ClipMaster. Він не просто читає сказане — він дивиться і слухає, щоб зрозуміти, як було сказано і як реагували люди. Результатом є кліпи, які фіксують справжні моменти енергії, а не лише тематично релевантні текстові уривки.
Оцінка та ранжування кліпів
Після того, як ШІ обробив усі три потоки, він генерує набір кандидатів на кліпи та оцінює кожен з них. Модель оцінки враховує кілька факторів:
- Потенціал залучення. Наскільки ймовірно, що цей кліп утримає увагу глядача від початку до кінця? Кліпи з сильним початком і чітким завершенням отримують вищі бали.
- Автономна послідовність. Чи має кліп сенс без додаткового контексту? Момент, який вимагає п'яти хвилин підготовки для розуміння, отримує нижчий бал, ніж той, що є самозрозумілим.
- Емоційна арка. Найкращі короткі кліпи мають мікро-наратив — зав'язку, кульмінацію та розв'язку. ШІ шукає цю арку в кожному сегменті-кандидаті.
- Технічна якість. Кліпи, де спікер чітко видно, звук чистий, а кадрування стабільне, отримують вищі бали, ніж кліпи з низькою якістю виробництва.
Результатом є ранжований список кліпів, зазвичай відсортований за показником залучення. Автор переглядає їх, вносить корективи та експортує ті, що підходять.
Семантичний пошук відео: знаходження моментів за значенням
Однією з найпотужніших можливостей, що виникає з мультимодального аналізу, є семантичний пошук. Замість пошуку точних слів у транскрипті, семантичний пошук дозволяє вам описати те, що ви шукаєте, природною мовою, а ШІ знаходить відповідні моменти — навіть якщо ці точні слова ніколи не були вимовлені.
Наприклад, пошук «момент, коли гість не погоджується» знайде кліпи, де незгода виражається через мову тіла, тон і слова — а не лише кліпи, що містять слово «не погоджується». Це принципово відрізняється від пошуку за ключовими словами і значно швидше, ніж ручний перегляд матеріалу.
Чому це важливо для авторів
Перехід від транскрипції до мультимодального ШІ-кліпінгу — це не просто технічне вдосконалення; він змінює типи контенту, які можна ефективно кліпувати.
- Візуальний контент стає кліповим. Кулінарні демонстрації, огляди продуктів, фітнес-уроки та відеоблоги про подорожі значною мірою покладаються на візуальні матеріали. Інструменти, що базуються лише на транскрипті, мають з ними проблеми. Мультимодальні інструменти обробляють їх природно.
- Емоційні моменти фіксуються. Найкумедніші, найзворушливіші, найнесподіваніші моменти у відео визначаються емоціями, а не словами. Мультимодальний аналіз вловлює те, що текстовий аналіз не може.
- Редагування відчувається людським. Оскільки ШІ використовує ті ж сигнали, що й людський редактор — вираз, енергію, темп — отримані кліпи виглядають так, ніби їх вирізав хтось, хто насправді дивився відео.
Майбутнє
ШІ для нарізки відео стрімко вдосконалюється. Моделі краще розуміють контекст, гумор, наративну структуру та вподобання аудиторії. Наступний рубіж — персоналізація: ШІ, який навчається, які типи кліпів найкраще працюють для вашої конкретної аудиторії, і відповідно коригує свій вибір.
Але основний принцип залишиться незмінним: чим більше ШІ розуміє те, що він дивиться, тим кращими будуть його рішення щодо редагування. Мультимодальний аналіз — це не функція, це основа, яка відокремлює інструменти машинного навчання для відео, що створюють придатні для використання кліпи, від тих, що створюють чорнові нарізки. Якщо ви оцінюєте інструменти для нарізки відео на основі ШІ, перше питання, яке потрібно поставити, просте: чи він насправді дивиться відео, чи просто читає транскрипт?