Wie AI Video-Clipping funktioniert und warum es wichtig ist
KI-Videoclipping hat sich in weniger als zwei Jahren von der Spielerei zum echten Produktionswerkzeug entwickelt. Wofür früher ein menschlicher Cutter stundenlang Material sichten und Entscheidungen über Tempo und Emotion treffen musste, das erledigen Machine-Learning-Modelle heute in Minuten. Aber wie funktioniert das eigentlich? Und warum liefern manche Tools Clips, die sich natürlich anfühlen, während andere Videos an unpassenden, sinnlosen Stellen zerhacken?
Die Antwort liegt darin, was die KI tatsächlich analysiert. Nicht alle Tools für automatischen Videoschnitt sind gleich, und der Unterschied zwischen einem mittelmäßigen und einem richtig guten Tool hängt an einer einzigen Architekturentscheidung: ob sich das System nur das Transkript ansieht – oder das komplette audiovisuelle Signal.
Der reine Transkript-Ansatz
Die meisten KI-Clipping-Tools der ersten Generation funktionieren so: Sie wandeln den Ton per Spracherkennung in Text um, schicken das Transkript durch ein Sprachmodell und lassen es „interessante“ Abschnitte heraussuchen. Das Modell wählt Sätze, die wichtig wirken, ordnet sie wieder den Zeitstempeln zu und schneidet das Video an genau diesen Stellen.
Dieser Ansatz ist schnell und günstig umzusetzen. Er nutzt bestehende große Sprachmodelle, die Text sehr gut verstehen. Bei manchen Content-Arten – etwa Interviews mit klaren Kernaussagen – funktioniert das einigermaßen gut.
Aber er hat grundlegende blinde Flecken:
- Er kann nicht sehen. Rein visuelle Momente – eine Produktdemo, eine Reaktion, eine dramatische Enthüllung – sind für ein transkriptbasiertes System unsichtbar.
- Ihm entgehen Tonfall und Energie. Die Worte „das ist unglaublich“ können mit echter Begeisterung oder mit trockenem Sarkasmus fallen. Im Transkript sieht beides gleich aus.
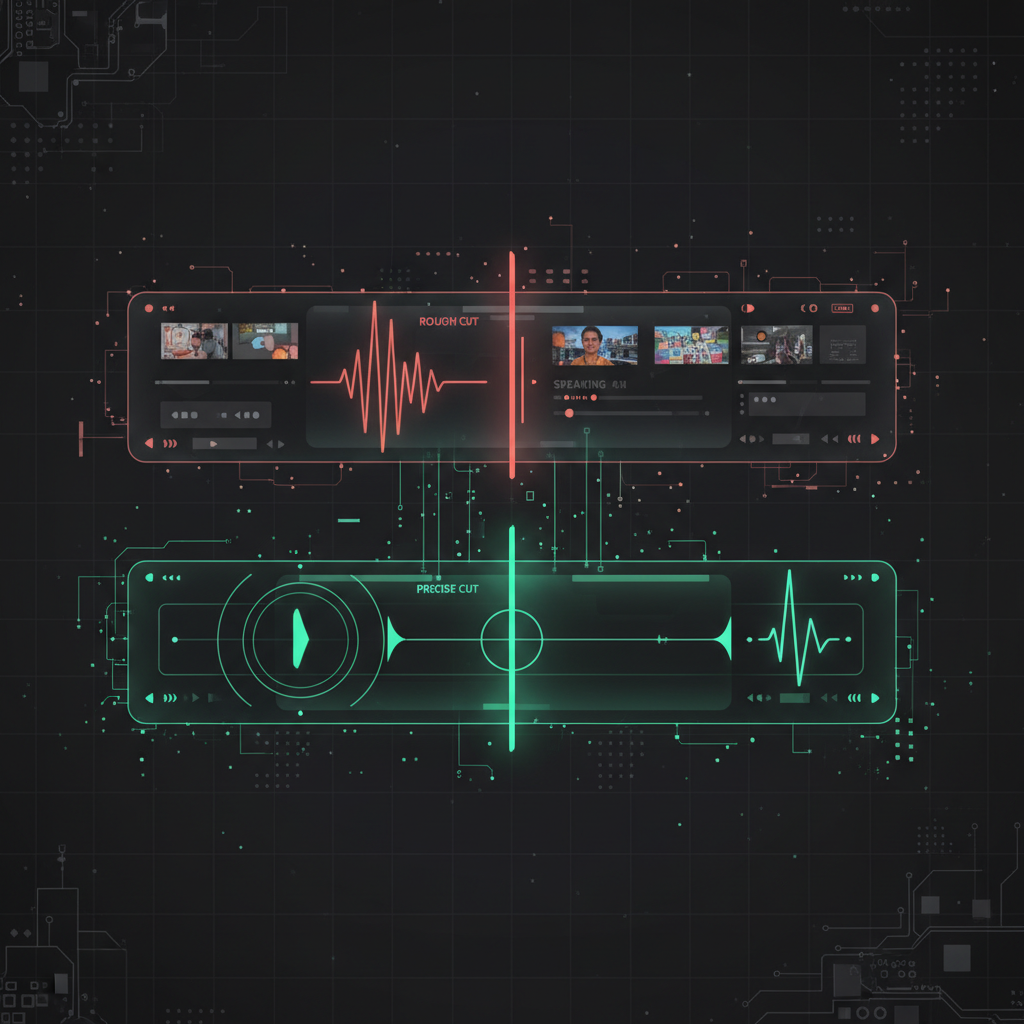
- Er schneidet an Satzgrenzen. Natürliche Schnittpunkte fallen selten mit dem Satzende zusammen. Ein starker Clip beginnt vielleicht mitten im Satz mit einer Reaktion und endet auf einem visuellen Beat.
- Er ignoriert das Tempo. Der Rhythmus eines Gesprächs – Pausen, Lachen, Durcheinanderreden – trägt emotionale Informationen, die Text allein nicht erfassen kann.
Reine Transkript-Tools liefern Clips, die thematisch passen, sich aber oft anfühlen, als hätte jemand ein Gespräch an zufälligen Stellen mit der Schere zerschnitten. Der Inhalt stimmt, das Timing nicht.
Der multimodale Ansatz: Bild- und Tonanalyse
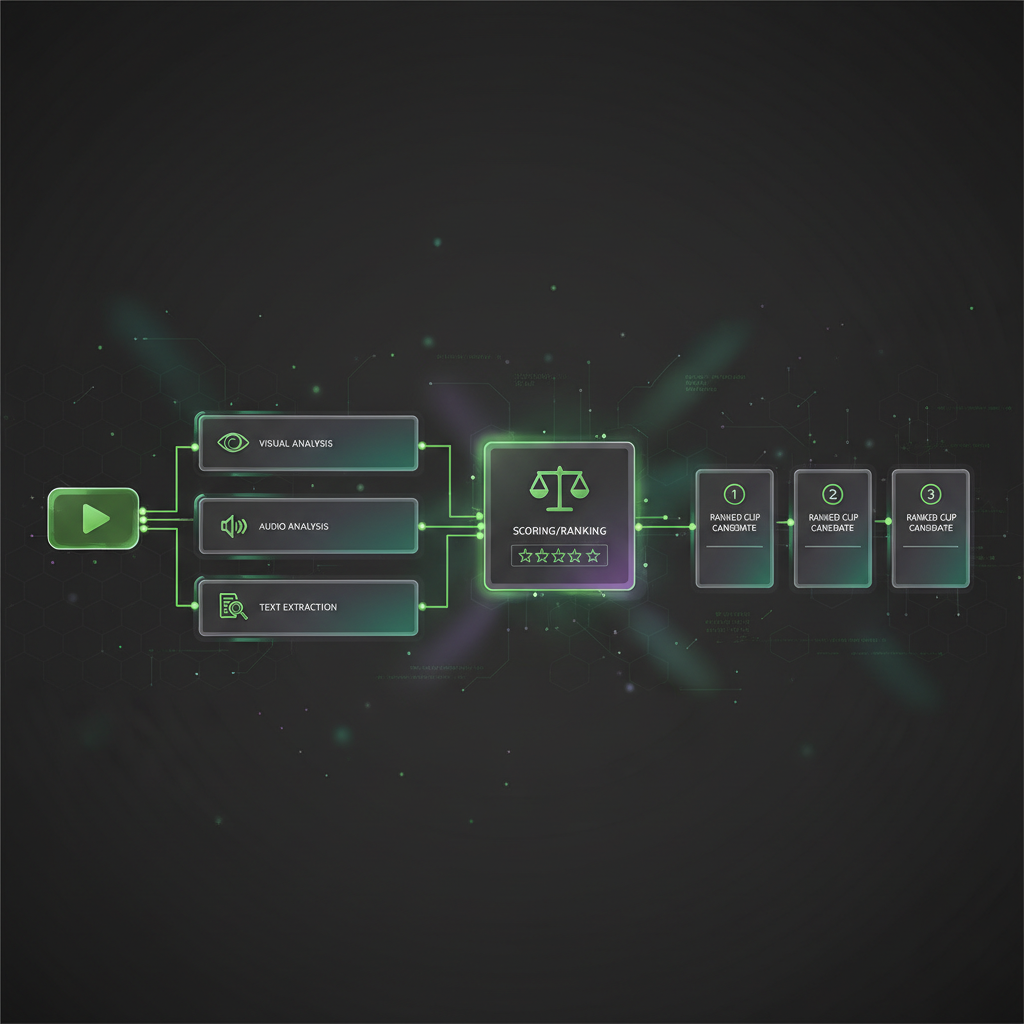
Ein multimodales KI-Videoclipping-System verarbeitet mehrere Datenströme gleichzeitig: die Frames, das Audiosignal und das Transkript. Jeder Strom liefert andere Informationen, und das System kombiniert sie zu Entscheidungen, die kein einzelner Strom allein tragen könnte.
Bildanalyse
Die Bildspur wird von Computer-Vision-Modellen verarbeitet, die mehrere Elemente erkennen und verfolgen:
- Szenenwechsel. Harte Schnitte, Überblendungen und deutliche Veränderungen im Bildaufbau signalisieren Übergänge zwischen Themen oder Abschnitten.
- Gesichtserkennung und -tracking. Das Modell erkennt, wer spricht, welche Mimik die Person zeigt und in welcher Gefühlslage sie ist. Eine hochgezogene Augenbraue, ein aufblitzendes Lächeln oder ein überraschter Blick – all das hat Bedeutung.
- Bewegung und Energie. Schnelle Gesten, sich nach vorn lehnen oder aufstehen zeigen Momente mit Nachdruck an. Statische Frames mit wenig Energie sind oft Füllmaterial.
- Elemente im Bild. Texteinblendungen, Folien, Produktaufnahmen oder geteilte Bildschirme können auf strukturierte Abschnitte hinweisen, die sich als eigenständige Clips lohnen.
Tonanalyse
Über die Transkription hinaus steckt schon im Audiosignal selbst jede Menge Information:
- Stimmenergie und Tonhöhe. Eine steigende Tonhöhe und mehr Lautstärke signalisieren Begeisterung oder Nachdruck. Diese Momente hängen stark mit dem Engagement der Zuschauer zusammen.
- Lachen und Reaktionen. Lachen im Publikum, erstauntes Aufatmen oder Applaus sind starke Clip-Marker, die reinen Transkript-Tools komplett entgehen.
- Stille und Pausen. Gezielte Pausen stehen oft vor oder nach wichtigen Aussagen. Außerdem sind sie natürliche Schnittpunkte.
- Musik und Sounddesign. Wechsel in der Hintergrundmusik, Soundeffekte oder Intro- und Outro-Jingles helfen der KI, strukturelle Grenzen in produziertem Content zu erkennen.
Die Signale kombinieren
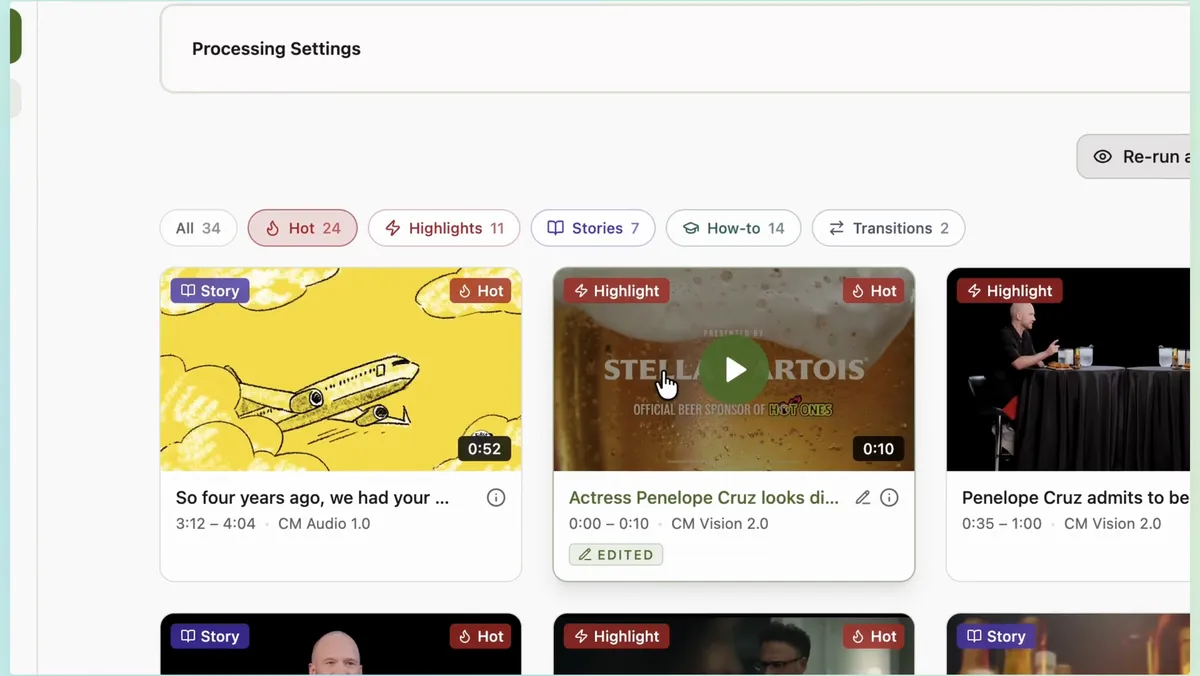
Die eigentliche Stärke zeigt sich, wenn diese Ströme zusammengeführt werden. Stell dir einen Podcast vor, in dem der Host etwas halbwegs Interessantes sagt – das Transkript allein würde es vielleicht gar nicht markieren. Aber wenn der Gast die Augen aufreißt, sich nach vorn lehnt, seine Stimme nach oben springt und er mit „Moment, sag das noch mal“ dazwischengeht, erkennt das multimodale System einen Moment mit hohem Engagement – weil alle Signale in dieselbe Richtung zeigen.
Genau so arbeitet die KI von ClipMaster. Sie liest nicht nur, was gesagt wurde – sie schaut und hört hin, um zu verstehen, wie etwas gesagt wurde und wie die Leute reagiert haben. Das Ergebnis sind Clips, die echte Energie-Momente einfangen, nicht nur thematisch passende Textpassagen.
Clips bewerten und sortieren
Sobald die KI alle drei Ströme verarbeitet hat, erzeugt sie eine Reihe von Clip-Kandidaten und bewertet jeden einzelnen. Das Bewertungsmodell berücksichtigt mehrere Faktoren:
- Engagement-Potenzial. Wie wahrscheinlich hält dieser Clip die Aufmerksamkeit der Zuschauer von Anfang bis Ende? Clips mit starkem Einstieg und klarer Auflösung schneiden besser ab.
- Für sich verständlich. Ergibt der Clip ohne zusätzlichen Kontext Sinn? Ein Moment, der fünf Minuten Vorlauf braucht, um verständlich zu sein, bekommt einen niedrigeren Score als einer, der für sich selbst spricht.
- Emotionaler Bogen. Die besten Kurzclips haben eine Mini-Erzählung – einen Aufbau, einen Höhepunkt und eine Auflösung. Die KI sucht in jedem Kandidaten nach diesem Bogen.
- Technische Qualität. Clips, in denen die sprechende Person gut zu sehen ist, der Ton sauber ist und der Bildausschnitt ruhig bleibt, schneiden besser ab als Clips mit schwacher Produktionsqualität.
Am Ende steht eine Rangliste von Clips, meist nach Engagement-Score sortiert. Der Creator sichtet sie, passt an und exportiert die, die funktionieren.
Semantische Videosuche: Momente nach Bedeutung finden
Eine der stärksten Fähigkeiten, die aus der multimodalen Analyse entsteht, ist die semantische Suche. Statt nach exakten Wörtern im Transkript zu suchen, beschreibst du in natürlicher Sprache, wonach du suchst, und die KI findet passende Momente – auch wenn genau diese Worte nie gefallen sind.
Eine Suche nach „Moment, in dem der Gast widerspricht“ findet zum Beispiel Clips, in denen sich Widerspruch über Körpersprache, Tonfall und Worte zeigt – nicht nur Clips, in denen das Wort „widersprechen“ vorkommt. Das ist etwas grundlegend anderes als eine Stichwortsuche und um ein Vielfaches schneller, als das Material von Hand durchzuspulen.
Warum das für Creator wichtig ist
Der Wechsel vom reinen Transkript-Clipping zum multimodalen KI-Clipping ist nicht nur eine technische Verbesserung – er verändert, welche Arten von Content sich überhaupt sinnvoll clippen lassen.
- Visueller Content wird clipbar. Kochdemos, Produktreviews, Fitness-Tutorials und Reisevlogs leben stark vom Bild. Reine Transkript-Tools tun sich damit schwer. Multimodale Tools kommen ganz selbstverständlich damit klar.
- Emotionale Momente werden eingefangen. Die lustigsten, berührendsten und überraschendsten Momente eines Videos definieren sich über Emotion, nicht über Worte. Die multimodale Analyse erfasst, was eine Textanalyse nicht kann.
- Der Schnitt wirkt menschlich. Weil die KI dieselben Signale nutzt wie ein menschlicher Cutter – Mimik, Energie, Tempo –, wirken die Clips, als hätte sie jemand geschnitten, der sich das Video wirklich angesehen hat.
Wie es weitergeht
KI-Videoclipping wird rasant besser. Die Modelle verstehen Kontext, Humor, Erzählstruktur und Publikumsvorlieben immer besser. Die nächste Stufe ist Personalisierung – eine KI, die lernt, welche Arten von Clips bei deinem Publikum am besten laufen, und ihre Auswahl entsprechend anpasst.
Das Grundprinzip bleibt aber dasselbe: Je mehr die KI von dem versteht, was sie sich ansieht, desto besser werden ihre Schnittentscheidungen. Multimodale Analyse ist kein Feature – sie ist das Fundament, das Machine-Learning-Videotools, die brauchbare Clips liefern, von denen trennt, die nur Rohschnitte ausspucken. Wenn du KI-Clipping-Tools vergleichst, ist die erste Frage ganz einfach: Sieht sich das Tool das Video wirklich an – oder liest es nur das Transkript?